
外观
Emacs 社区日报 2026-10-12
自动整理自 Telegram 讨论组,每天更新。内容为 AI 摘要,仅作信息索引与回顾。
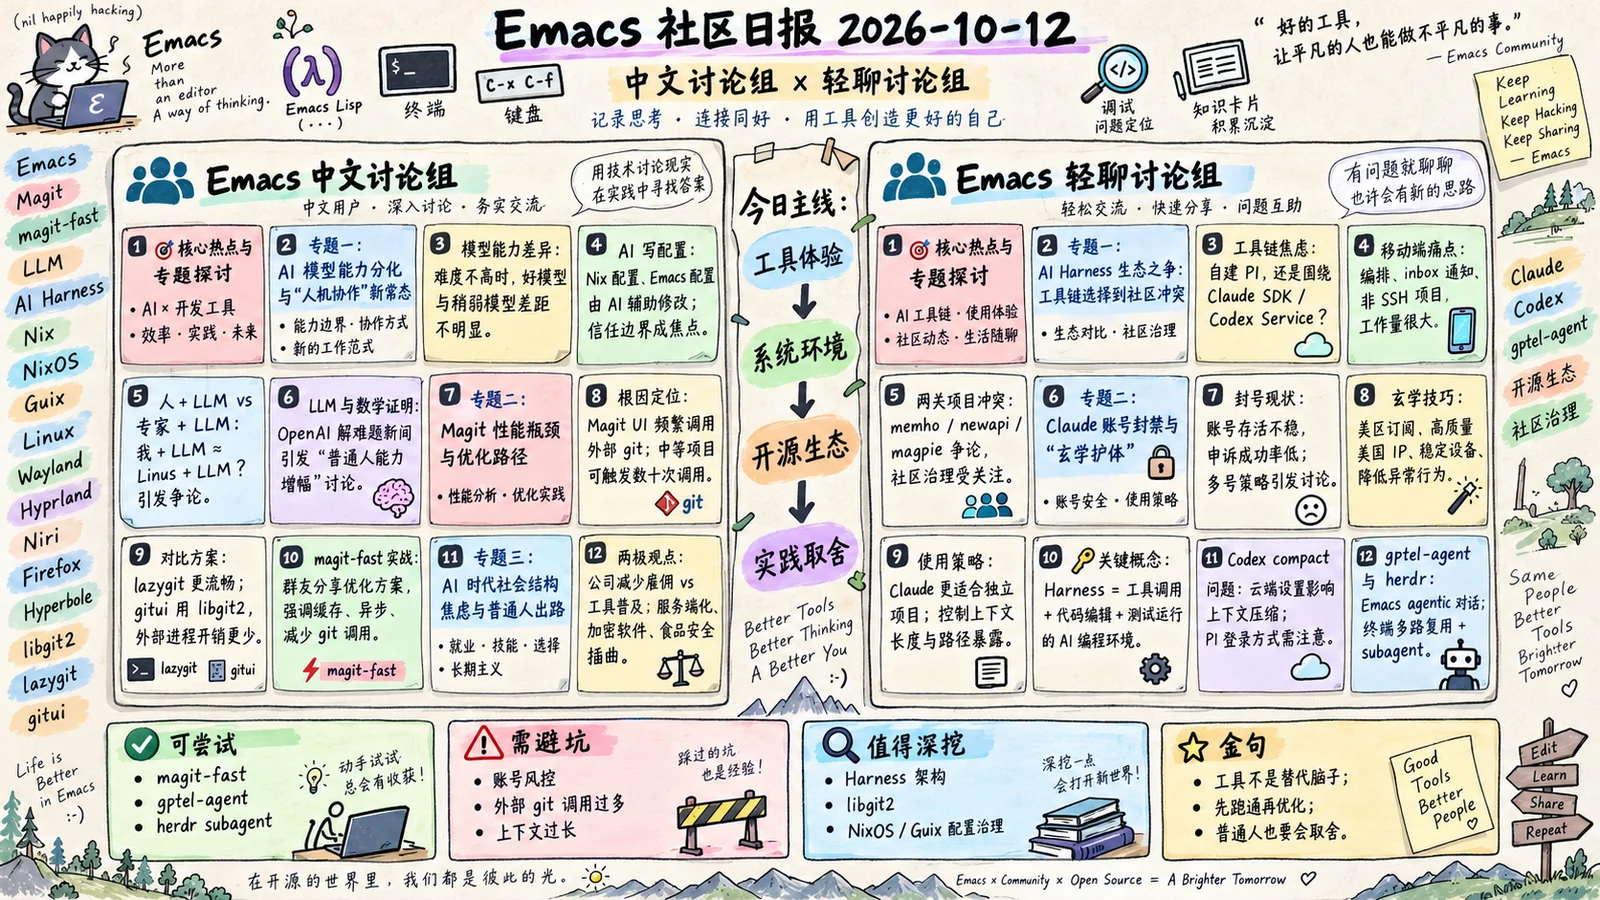
Emacs 中文讨论组
🎯 核心热点与专题探讨
专题一:AI 模型能力分化与“人机协作”新常态
群内围绕多个前沿 AI 模型(DS、Fable、Astra、Claude 等)展开了横跨代码生成、配置管理、调试排错、数学证明等场景的深度对比,核心焦点在于“模型差异是否真的重要”以及“人类与 AI 的最佳分工”。
- 模型能力差异的真实感知:多数成员认为,对于“难度不特别复杂”的任务,好模型与稍差模型的差距并不明显(
vritser表示“目前用下来感觉没啥区别”)。但调试场景是分水岭——“特别是 debug 的时候,和前沿模型有天壤之别”。有成员用 Astra 与 DS 双向 review 代码,互相找 bug,说明模型间的差异在复杂场景下会放大。 - AI 写配置的信任边界:有成员坦言“我的整个 nix 配置都是 ai 写的”“emacs 配置目前也全部是 ai 帮我改了”,但也有成员表示“配置我是不敢让 AI 去改”,担心 AI 改坏自己难以排查。折中方案是“自己写签名,AI 写实现”,或者加上
AGENTS.md+ 约束 skill 后再让 AI 动手。 - 人 + LLM vs. 专家 + LLM 的差距:有人提出“我 + LLM 可以约等于 Linus + LLM 吗?”引发争论。一方认为“拉开两个人的能力的不再是技术了”,另一方反驳“你和 Linus 专长并不一致”“给 LLM 指出方向还是很重要的”。最终共识偏向:LLM 是技术层面的杠杆,领域知识、思路、判断力仍是人类的核心价值(
κόσμος强调“不是领域专家很难形成有效的思路”)。 - LLM 与数学证明的争议:有成员分享 OpenAI 用 LLM 解决顶尖数学家难题的新闻,引发激烈讨论。一方认为“普通人有了 LLM 可以做到以前做不了的事”,另一方质疑 LLM 证明的等价性与审稿成本(“openai 纯纯把数学家当免费审稿人用”),还提到“llm 用 lean 等证明辅助工具跑出来的命题有部分是不等价于他们声明的结论的”。
专题二:Magit 性能瓶颈与优化路径(含 magit-fast 实战)
从“magit 在 mac 上卡”这一痛点出发,深入剖析了 Magit 的架构问题与优化空间。
- 根因定位:Magit 的每个 UI 元素信息都通过调用外部
git进程获取,打开一次中等项目后台 git 调用可达 26~50 次(优化后 vs 未优化),且毫无缓存。Windows 上git.exe启动开销大,导致“卡得离谱”。 - 对比方案:lazygit 同样直接调用 git 命令行,但更流畅;gitui 使用 libgit2(无外部进程),性能差距显著。有成员指出“magit 也能用 libgit”,但 libgit2 功能覆盖不全,且 git 持续更新,维护成本高。
- magit-fast 的实践:群友
zHaODanNiu分享了自己的 magit-fast 优化方案(开源在 GitHub),通过减少 git 调用次数(打开时只调 2~3 次)大幅提升体验,并展示了 Windows 上的流畅视频。“magit 就是写的烂吧”引发反驳:“magit 有很多功能,劃時代的領先,不能說爛,只是沒有很在意性能。”
专题三:AI 时代的社会结构焦虑与“普通人”的出路
从“数学家被 LLM 替代”聊到“毕业生可怜”“大公司统治一切”“人类完蛋了”,话题蔓延至食品工业、欧洲福利社会、杰文斯悖论等。
- 悲观与乐观的两极:一方认为“公司不需要雇佣员工做事情了”“普通人跟不上,有点天赋才行”“毕业的学生比较可怜”;另一方则指出“有了 LLM,人就有更多精力去探索了”“每个人都不敢尝试不熟悉的领域”。
- 关于未来制度的讨论:有人提出“以后软件会继续加密”“一切都在服务端”“你永远都无法拥有一个软件了”;也有人认为“只要能在用户电脑上执行,加密是没用的”,并讨论 UBI、大逃杀等极端情景。
- 食品安全的插曲:从 LLM 转向食品工业与食品安全,提到欧洲“随便进一个商店买的食物都可以放心安全”、国内“山姆超市质量有保障且算下来便宜”、日本茶产业化比国内强等。
κόσμος指出“食物生产效率提升 -> 成本降低 -> 食物需求更多”是杰文斯悖论的经典体现。
🔑 关键概念与技术解析
C-u M-:(Emacs 执行 elisp 并插入结果):在 Emacs 中,M-:可交互执行 elisp 表达式;加上C-u前缀后,执行结果会被插入到当前光标位置,适合快速计算或生成文本片段。AGENTS.md(AI 约束规范文件):一种为 AI 协作工具(如 code agent)编写的项目级约束文件,用于限定 AI 的行为边界、代码风格、测试要求等。群友认为“加上 AGENTS.md + 约束 skill 之后,AI 改配置应该也能改”。
Clean room(净室工程):一种避免版权侵权的开发方法,让一组人只看外部规范、另一组人独立实现。群友调侃“AI 时代的 clean room”——让 AI 理解需求后人工重写。
libgit2(Git 的库实现):一个以库形式提供的 Git 实现,无需调用外部
git命令,性能更高(如 gitui 使用)。但功能覆盖不全,且与 git 更新不同步,维护成本高。杰文斯悖论(Jevons Paradox):资源效率提升反而导致资源消耗增加的现象。此处用于解释食品生产效率提升后,食品需求反而增加(如“肉也不是能天天吃上”到“天天能吃上肉”)。
dsh-emacs(DS 客户端前端):
dsh的 Emacs 客户端,由群友开发,可直接在 Emacs 内使用 DS 模型。有成员反馈“在 macOS 似乎有奇怪的行为,确认的窗口跑边缘去了”。
💎 碎片知识与金句拾遗
- “AI 写的代码总是很复杂,而且会抽一些莫名其妙的公共函数。不如自己写签名,AI 写实现。” —— 一种实用的 AI 协作策略:人类掌控接口,AI 填充实现。
- “我们以为的困难的任务,其对 AI 来说可能并不困难。两者对困难理解的阈值是不一样的。” —— 对 AI 能力边界的深刻观察。
- “思考几分钟的结果不如 astra 瞬答。” —— 对比不同模型在简单任务上的即时性差异。
- “有了 code agent 之后给几乎每个函数或者功能加测试不再是不可能的事情了。” —— code agent 带来的测试覆盖率革命。
- “LLM 与知识储备和技能应该是互补的。完全用 LLM 做项目,感觉就是个坑。” —— 强调人机互补,而非替代。
- “LLM 时代,拉开两个人的能力的不再是技术了。说不定差不多。” —— 一种略带悲观的能力拉平论。
- “普通人有能力做事了,但大部分人也没啥意识。” —— 新技术时代的意识滞后。
- “现在的大学生只恨 AI 发展速度还不够快,不够将当前的工作体系摧毁。” —— 对年轻人心态的锐评。
- “LLM 就跟个霍金一样。” —— 对 LLM 强大但受限的比喻。
- “magit 的每一个 UI 元素的信息都是调 git 去获得的,毕竟毫无缓存。” —— Magit 性能问题的直接解剖。
- “同样是 cli 工具,gdb 既有 -i=mi 可以直接支撑 emacs 里面 many windows 的 ui,也有自带的 gdbtui。对比来看,git 这些东西很长时间都是缺乏的。” —— 为什么 git 系工具难做 GUI 的历史解释。
- “对,就是组件,整个 app 都是基于可复用的组件构建的。” —— 群友介绍 etaf 框架的组件化理念。
- “太难了,我玩了 3 局了,第一关都没过去。我要搞一个难度调整的功能。” —— 群友分享自己开发游戏时的真实体验。
🛠️ 值得深入研究的点 (Follow-up)
magit-fast(https://github.com/zHaOdANiuu/magit-fast):针对 Magit 性能问题的第三方优化方案,通过减少 git 调用次数大幅提升体验。群友实测在 Windows 上效果显著,值得追踪其实现思路(是否涉及缓存、批量 git 调用等)。
diffs.el(Emacs diff 查看器):群友自制的“看看 diff 还行”的 Emacs 插件,可作为轻量级 review 工具进一步探索,结合 AI review 工作流可能很有价值。
etaf(组件化 UI 框架):群友正在开发的组件化框架,适合做 buffer 内 widget、webview2 标签栏等。尚未正式发布,但理念新颖(“整个 app 都是基于可复用的组件构建”)。
ox-w3ctr(https://github.com/include-yy/ox-w3ctr/pull/1):由 Fable 生成的 Org-mode 导出器 PR,属于“AI 时代的 clean room”实践,可作为 AI 辅助开源开发的案例研究。
gitui(libgit2 终端客户端):群友提到“真流畅的你试试 gitui”,其基于 libgit2 的架构值得研究,作为对比 Magit 性能问题的参照系。
观点延伸
当天最值得咀嚼的,不是“哪个模型更强”,而是一个更具体的判断:AI 正在把编程的瓶颈,从“写出代码”推向“能否提出正确问题、建立验证边界,并看懂结果”。这也是为什么有人觉得 Fable、DS、Astra 在普通任务上差别不大,却在 debug、复杂配置和跨领域问题上出现明显分化。
1. AI 协作的核心不是让模型接管,而是把接口和验收权拿回来
群里那句“自己写签名,AI 写实现”很有普适性。它不是保守,而是在重新划分责任:人负责定义数据结构、边界条件和不可破坏的行为,模型负责填充实现、生成测试、尝试替代方案。配置文件尤其如此。5000 多行 Emacs 或 Nix 配置并不只是代码,也是个人工作流的隐性知识;模型可以帮忙重构,却很难独立判断哪些“奇怪写法”其实是多年积累出来的兼容性约束。
因此,AGENTS.md、测试和约束并不是给模型看的说明书,而是把个人经验外显成可检查的工程规则。没有规则时,测试可能只是“把模型写出的行为再确认一遍”;有明确不变量、失败样例和端到端验证时,测试才会成为人机之间的共同语言。
2. Emacs 的价值,可能从“编写环境”转向“审阅环境”
群里有人说,AI 时代 Emacs 反而更重要,因为仍然需要 review;也有人希望获得类似 GitHub review 的体验,却被 Magit、Ediff 的性能和交互拖住。这里有一个很现实的连接:当代码生成越来越便宜,审阅界面的质量就不再是附属体验,而是生产力的主战场。
Magit 的争论也说明,功能先进不等于架构适合当前硬件和使用场景。每个 UI 元素反复启动 git、缺乏缓存,在 Linux 上可能被较低的进程启动成本掩盖,在 macOS 和 Windows 上就会变成明显的交互债务。magit-fast 将调用次数从数十次压到两三次,说明很多“系统级卡顿”未必需要重写整个工具,先减少重复工作就可能获得数量级改善。
可继续研究/实践
可以把“AI 生成—Emacs 审阅—自动验证”做成一条可测量的工作流:选一个真实配置或小型 Lisp 项目,记录模型修改前后的 diff、测试覆盖、回滚次数、人工审阅时间,再比较单模型生成、双模型互审和人工先定接口三种方式。与此同时,对 Magit 或 diffs.el 记录一次 review 中的进程调用、等待时间和定位成本。真正值得优化的,可能不是模型再快一点,而是让人更快发现它错在哪里。
Emacs 轻聊讨论组
🎯 核心热点与专题探讨
专题一:AI Harness 生态之争——从工具链选择到社区撕逼
群内凌晨时段围绕 AI harness(编程框架/工具集)的讨论异常激烈,核心矛盾集中在“自研 vs 生态复用”的选择困境与社区竞争乱象上。
- 工具链选择焦虑:有成员表示“从生态上,要么自己整一个 pi 的,要么围绕 Claude SDK 或 Codex Service 或 DSH 构建”,而体验新 harness 的工作量同样不小。最终有人选择“改了一下自己的 pi subagent 插件,让它可以直接调用别人的 harness 来完成工作”,形成了一种“搭配着模型”的灵活组合方案。
- 移动端痛点:有成员指出“涉及手机端的还涉及编排和 inbox 通知,并且是非 ssh 项目才是真的工作量大”,试过之后发现“moshi 对我来说就是神了”——说明在复杂场景下,工具选择往往会被一两个关键痛点所主导。
- 网关项目冲突:深夜时段爆发了 memho、newapi 官方开发组成员与 magpie 作者之间的争吵。有成员犀利批评:“呼声那么大,别人刚刚做出 magpie 响应,newapi 项目立马整一个 astrlink.com 用来管理多 agent……现在又跳出来整这活”,并质疑“前两者还是有灰产嫌疑的接受赞助和订阅项目”。多位成员表达了“双标到令我害怕”的愤怒,直指利益驱动的站队行为。
专题二:Claude 账号封禁与玄学护体
白天时段围绕 Claude Max 订阅被封号的问题展开了热烈讨论,多位成员分享了亲身经历和“防封玄学”。
- 封号现状:有成员抱怨“A\ 的封了一千多万,申诉成功的只有 4.2万”,另一位坦言“我第二个号只活了一夜”。更有成员称“我第一个号三个月 第二个号小于一天”,可见封号不确定性极高。
- 玄学技巧总结:一位成员分享了四条实战经验:1. 用美区 App Store 订阅;2. 找一个高质量的美国 IP 专门走 Claude 流量(配合 Clash 扩展脚本);3. 系统设成英文,时区改成新加坡;4. 不要让 A\ 误以为你在蒸馏。后续讨论确认中文会话不影响使用,新加坡同事也用中文,说明语言并非触发因素。
- 使用策略反思:有成员认为“claude最好只拿来开发比较独立的项目”,并分享“我一般会不停的/new”来规避上下文过长导致的消耗过快问题。另一位则推荐“长任务让 opus 规划 todo list,不同任务用不同模型,开 subagent 跑”,有效管理配额。
🔑 关键概念与技术解析
- Harness(AI 编程框架/工具集):指围绕大模型构建的完整编程执行环境,包含工具调用、代码编辑、测试运行等能力。群内讨论的核心在于不同 harness(PI、Codex、Moshi)的生态成熟度与使用体验差异。
- Codex 云端设置导致的 compact 问题:PI(一个 AI 编程环境)中直接使用 ChatGPT 登录时,compact 机制并非 OpenAI 原生远程压缩,需要额外插件(pi-openai-server-compaction)修复,但该插件存在已知 BUG。后续版本似乎已修复。
- gptel-agent:Emacs 中的 AI agent 插件,支持在 Emacs 内进行 agentic 对话。群内讨论指出其“只有 agent,没有 harness,适合单次任务执行”,长任务能力不足。
- herdr:类似 tmux 的终端多路复用工具,支持通过 subagent 插件与 AI 结合使用,iOS 端已有控制端(Heeler)。
- warpd / Homerow / Shortcat 等全屏键盘导航工具:通过全屏铺满字母标签或扫描 UI 元素,实现无需鼠标的键控光标操作。其中 warpd 采用全屏坐标网格模式,不依赖应用类型;Homerow 基于 macOS Accessibility API 自动识别控件。
- Dvorak programmer 键盘布局:程序员专用 Dvorak 变体,支持符号键位优化。群内讨论其可能逐渐不被 Linux 默认支持,Debian tty 已无内置,需从 xkbd 手动 parse。
💎 碎片知识与金句拾遗
- “那种搭配着模型的感觉这样做应该会好一些”——关于组合不同 harness 的尝试体验。
- “模型现在都会隐藏思考链了 - -。” ——对 GPT 等模型隐藏推理过程的无奈。
- “关键的一点是现有的决策全基于已有的人类的知识经验,我并不认为这是通往智能的道路。” ——对 AGI 路线的批判性思考。
- “LLM公司现在几乎就把幻觉当作免死金牌,不管出了什么问题,我已提前告知你有幻觉,需要自己分辨。” ——对 AI 厂商推责文化的讽刺。
- “如果完全不看产品质量,只看产品成果的方式并不适合所有领域,目前为止,最简单的编码领域还是没有被替代。” ——对当前 AI 能力边界的中肯判断。
- “就如果完全不看产品质量,只看产品成果的方式并不适合所有领域” ——强调过程透明的重要性,呼应“架构怎么漂移的都不知道”的痛点。
- “我是笔记本 ai让我加压风散热底座,他说做隔音柜不现实🫠”——笔记本散热困境的幽默表达。
- “我的时间线里面今天全是吵架”——对社区氛围的整体感受。
- “当年换布局真是脑子抽了”——对切换到 Dvorak 布局的后悔,以及“换回去不会打字,会和肌肉记忆搏斗”的进退两难。
- “我还是喜欢以前 cursor 的那种方式。现在的 agentic 对话,把这个过程完全封装了,有问题啊——反馈的 tool calling 也没啥用,还是要实际看看。” ——对 agentic 编程范式丧失过程可控性的担忧。
- “我觉得发展上限有限” ——针对隐藏思考链趋势的判断。
- “先进入那个都是色情链接的群就能加了👀”——调侃加入某技术群的捷径。
- “我去年这个时候3.4k买过一个日版的pro m1,16+512”——分享二手 M1 MacBook Pro 参考价格。
- “我也很拧巴,喜欢不怎么宣传但是好用的东西。一个劲宣传的东西,我会试用一次,不行就不再尝试。”——对产品营销态度的个人偏好。
- “我目前想的是给他放在另一个屋子”——应对主机噪音的朴素方案。
- “南京路那块…上海居然有这种地方”——对上海街头小市民氛围的意外发现。
- “我戾气也很重”——承认当前普遍社会情绪,随后引申到“暴力事件会增多”的担忧。
🛠️ 值得深入研究的点 (Follow-up)
- magpie 项目及周边生态:作为社区激烈争论的中心,magpie 代表了 AI 网关领域的新玩家。建议深入研究其技术架构、功能特性(尤其是“响应式多 agent 管理”能力),并关注其与 memho/newapi 等既有网关的竞争关系。
- PI 的 subagent 插件机制:群内多次提到通过修改 PI 插件来调用其他 harness 的工作方式,这种“插件化 harness 组合”思路极具可扩展性,值得进一步探索其 API 与生态。
- gptel-agent 的 agent 能力演进:尽管被指“只有 agent,没有 harness”,但其原生 Emacs 集成体验依然受到认可。可关注其后续版本是否会补充 harness 能力,以及与其他 Emacs AI 工具(如 superchat)的集成深度。
- warpd 等全屏键盘导航工具:这类工具在终端、远程桌面、自绘 GUI 场景下表现突出,作为“无鼠标化”工作流的核心组件,值得深入研究其跨平台实现(X11/Wayland/macOS)及性能优化。
- herdr 的 iOS 控制端(Heeler):该项目将终端管理扩展到移动端,代表了“随时随地接入开发环境”的趋势,建议关注其同步机制与安全性设计。
- Dvorak programmer 布局的 Linux 支持现状:随着 Debian tty 移除默认支持,该布局的维护状态值得追踪。群内成员考虑迁移至标准 Dvorak 或硬件方案,可进一步调研替代布局的兼容性与社区维护情况。
观点延伸
当天最值得咀嚼的,不是“Pi、Codex、Claude 谁更好”,而是一个更硬的判断:AI 编程工具的核心竞争力,正在从模型能力转向工程控制能力。群里有人说,换一个 harness 的成本不只在安装和试用,还包括手机端编排、Inbox 通知、非 SSH 项目的接入;也有人发现,同一个 GPT 放进 Pi 里比直接使用 Codex 更稳定。这说明模型只是执行单元,真正决定体验的是上下文如何组织、工具如何暴露、失败如何恢复,以及人能否及时看见过程。
1. Harness 不是外壳,而是反馈回路
如果一个系统只展示最终 diff,却把中间的工具调用、上下文压缩、任务拆分和错误恢复全部封装起来,那么它实际削弱了人的调试能力。群里对 agentic 对话的担忧很准确:只看结果,往往无法知道架构是怎样逐步漂移的;等测试失败时,错误可能已经扩散到多个文件和决策。
因此,评价 harness 不应只问“能不能把功能写出来”,还要问四件事:任务是否可暂停,关键决策是否可追踪,失败能否局部回滚,人在什么节点必须介入。长任务让模型规划 todo、拆分 subagent、主动 compact,本质上都不是提示词技巧,而是在重建一个可观测、可恢复的工程流水线。一个稍微慢一点但能让人看懂、能随时接管的系统,可能比一次生成更快但不可解释的系统更适合长期使用。
2. “可用”首先意味着可预期
Claude 账号反复被封、配额因长上下文迅速消耗、Codex 偶发请求错误,这些表面上是服务或账号问题,工程上却共同指向同一个结论:不稳定的外部依赖不能直接成为工作流的单点核心。所谓“玄学技巧”也许短期有效,但无法替代明确的故障边界。
更稳妥的做法,是把模型当作可替换资源:项目状态放在仓库、todo、测试和变更记录里,而不是某个长期 session 里;任务切成可以重新执行的小单元;不同模型承担规划、实现、审查等不同角色;关键结果通过测试和人工 review 验收。这样即使账号失效、模型切换或上下文丢失,工作仍能从外部状态恢复,而不是从头猜测。
可继续实践的方向:为现有 AI 编程环境做一次“控制面审计”——记录每个任务的输入、工具调用、上下文压缩、失败点和人工接管点,再验证能否在更换模型或清空 session 后复现同一任务。真正成熟的 harness,应该经得起这种替换与恢复测试。