
外观
Emacs 社区日报 2026-09-20
自动整理自 Telegram 讨论组,每天更新。内容为 AI 摘要,仅作信息索引与回顾。
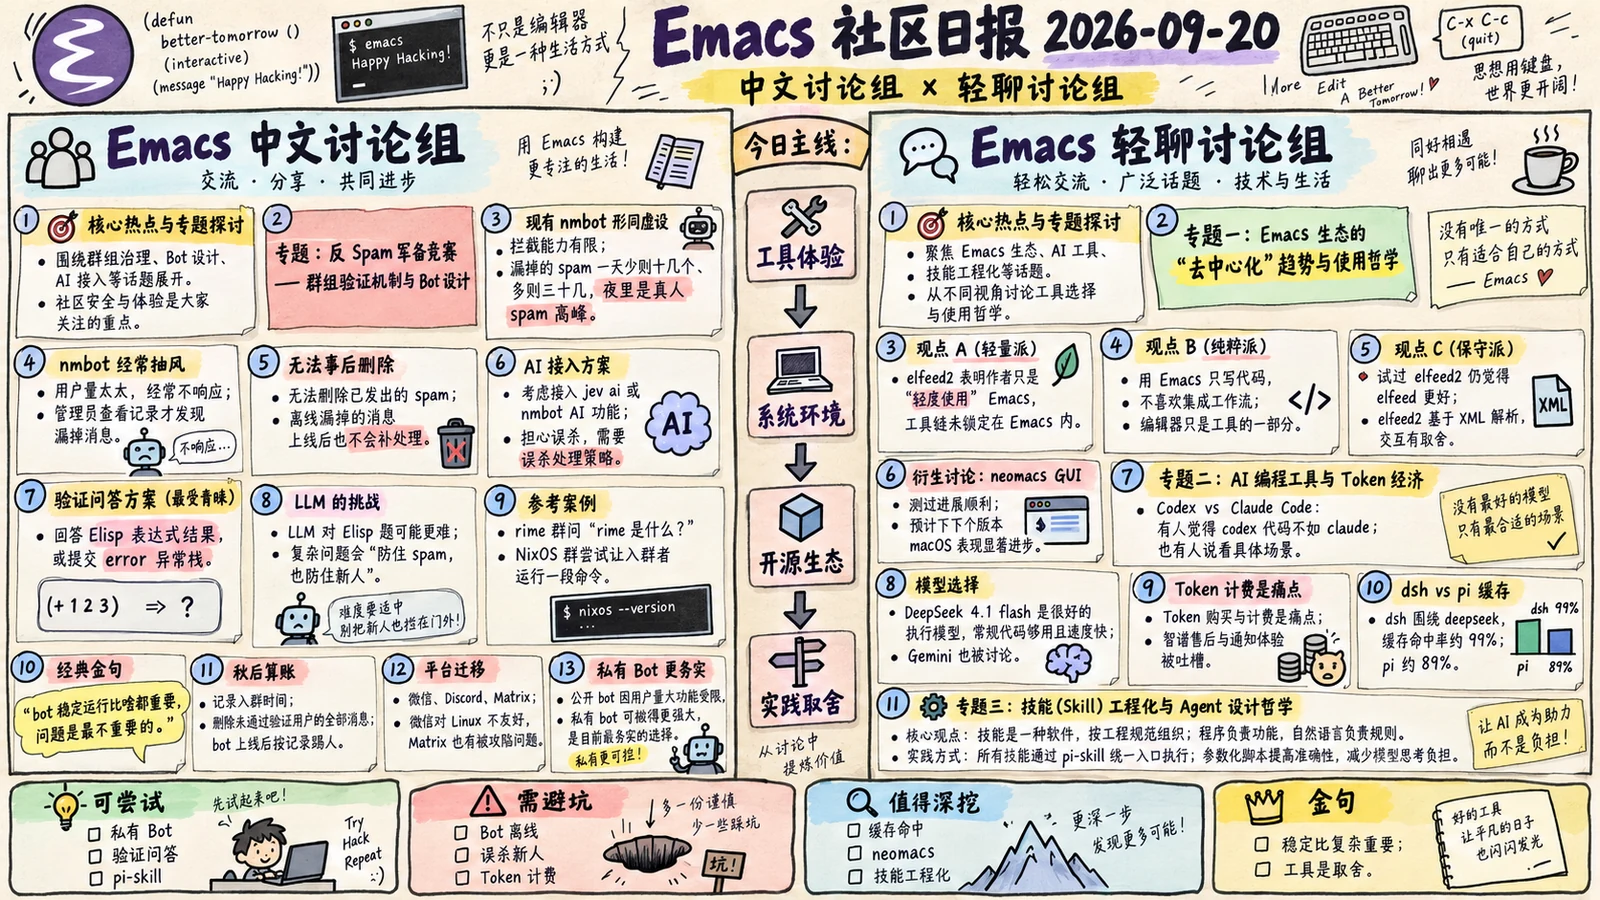
Emacs 中文讨论组
🎯 核心热点与专题探讨
【专题:反 Spam 军备竞赛——群组验证机制与 Bot 设计】
全天的讨论几乎都围绕着 Telegram 群组的 spam bot 问题展开,从 00:14 到 23:34 持续发酵,形成了本群最核心的技术探讨。
现状痛点:
- 现有 nmbot 形同虚设,拦截能力有限,漏掉的 spam 一天少则十几个、多则三十几,且多在夜里真人 spam 发言高峰。
- nmbot 因为用户量太大经常抽风(不响应),导致漏掉的 spam 无法及时处理。管理员去操作记录查看,会发现该时间段只有进群通知而没有 bot 回应。
- nmbot 无法事后删除已发出的 spam 消息,且离线期间漏掉的消息在上线后不会补处理。
方案讨论:
AI 接入方案:有人提议接入 jev ai(刚出来)或 nmbot 的 AI 功能,但担心会误杀,且需要考虑误杀处理策略。也有成员担心 spam 方会利用好模型来做对抗,但被反驳“spam bot 肯定不舍得用好模型”。
验证问答方案(最受青睐):
- 核心思路:让入群者回答一个 elisp 表达式的结果,或者给一个 error 贴异常栈。群里普遍认为 LLM 对 elisp 的括号处理能力很弱(“括号都数不对”“语料也少”),能有效区分真 Emacs 用户和 spam bot。
- 有成员补充:“只要你问了复杂的问题,不仅防住了 spam,也防住了新人。比如我是隔壁 Arch 群来的,第一次听说 Emacs 想进来看看。”即过度复杂的验证会误伤新人。
- 参考案例:rime 群就是简单问个“rime 是什么?”就能防止绝大多数 bot;NixOS 群那边曾尝试让你在电脑上运行一段 nix 指令来输出结果。
- 有成员指出:“bot 稳定运行比啥都重要,问题是最不重要的。你让 spam 回复个 hello 都够呛。”
秋后算账方案:记录所有用户入群时间,删除新入群但未通过验证用户的所有消息。即使 bot 临时不在线,上线后也能根据记录来踢人。但 nmbot 因为用户量太大,刷离线消息不现实。
平台迁移论:有成员提议换平台(微信、Discord、Matrix),但微信对 Linux 不友好,Matrix 也被攻陷了,最终结论是“tg 生态太过于自由,大家扎堆 tg”。也有成员认为这是对 spam 认输,不应当回避问题。
私有 Bot 方案:最务实的结论。公开 bot 因用户量大很多功能故意不做,自己做私有 bot 可以做得很强大。隔壁合租群和 rime 群都是私有 bot,非常稳定。
Cloudflare Worker 方案:有成员提议用 Cloudflare Worker 免费额度跑独立 bot,但需要评估免费额度是否满足群开销。
群友触发方案:设计成群友出发的机制,比如引用营销信息然后@bot,而非 bot 实时审查所有聊天记录(后者会比较耗资源)。
🔑 关键概念与技术解析
magit-status-quick:magit 自带的功能,默认打开时不会刷新,需手动按
g刷新。有成员将C-x g绑定在此功能上,因为默认不刷新比较合理。magit transient 卡顿:magit 是操作卡,按下快捷键后要卡一会才出现。有成员怀疑是 transient 的通病——先把所有 command 加载一遍再弹出 transient UI,magit 确实会自动加载所有组件。
nmbot / nmBot+:群内使用的公开 Telegram 管理 bot。订阅 nmBot+ 付费服务后才能删除被封禁用户的最近消息,群内引用了这个限制。
ACP(Agent Communication Protocol?):讨论到 fork-tree for agent-shell 时提到“任何支持 ACP 的 harness”,暗示这是 agent 相关的一个协议/接口标准。
org iOS app(未开源):群成员开发的一个基于 treesitter parser 的 org-mode iOS 应用,dashboard 和 calendar 对应 org-agenda 的两部分,edit 和 preview 照搬了之前写的 parser。成本约三百多 token,开发周期消耗一周。
💎 碎片知识与金句拾遗
Windows 上 Emacs 的 IO/路径查找开销:有成员分享配置经验——通过
exec-suffixes和移除find-file-hook、before-save-hook等 hook 可省掉大半executable-find开销。测试方法是M-x debug-on-entry executable-find RET,再用 process 监控看后台调用。“路径查找开销根据我的分析大于 io 开销”。AI 生成 app 的开发成本:有人用 AI 开发 iOS app(org 相关),消耗了一周的 token,成本三百多。群友调侃:“古人开发 app:细心微调,给 apple 的各个特性添加原生支持;现代人开发 app:帮我给各种操作添加适当的 haptic engine 支持”。
开源思路:“我应该把 app 开源之后,每个人都可以 fork 出来用 AI 加上自己想要的功能,比如用 roam 的加一个 roam 的 tab”。
有趣项目:有人分享了一个 GitHub 项目
https://github.com/Limenforge/emskin,评价为“神奇”,但未展开细节。bot 验证方案金句:“bot 稳定运行比啥都重要,问题是最不重要的。”——强调稳定性优先于验证复杂度。
群里现状吐槽:“刚人眼过了一遍,一眼 bot 的就刚踢的几个”“感觉群里潜伏了好多 spam bot”“快进到哪天百鬼夜行”。夜里是真人 spam 发言高峰。
开源生态观察:“我用 roam 的,自己加一个 roam 的 tab”——暗示未来 AI 生成代码 + 开源定制化的开发模式。
🛠️ 值得深入研究的点 (Follow-up)
基于 elisp 表达式的入群验证 Bot:群里最成熟的方案,既能防 spam 又能筛选出真正的 Emacs 用户。可作为私有 bot 的核心验证机制,参考 rime 群的“rime 是什么?”问答设计。关键点:表达式难度需要平衡——简单到真人能答对,复杂到 LLM 大概率答错。
fork-tree for agent-shell:支持 ACP 的 harness 重建 fork tree,多线程执行。这个项目尚未开源但具有潜力,值得关注 agent 生态的发展。
Org iOS App(开源计划中):基于 treesitter parser 的 org-mode 移动端实现,群成员计划开源。对于 Emacs/org 生态的移动端体验可能有重要价值,可作为后续关注的实践案例。
Cloudflare Worker 群管 Bot:用免费额度跑独立 bot 的思路,适合小型技术群。关键是离线消息的持久化记录和上线后的补处理机制。
观点延伸
当天最值得咀嚼的判断,不是“该用什么问题拦住 spam”,而是:社区防护系统的首要指标不是识别精度,而是持续可用性。群里反复提到,nmbot 漏放往往不是规则不够聪明,而是 bot 抽风、离线、来不及调用 API;甚至有人直说:“bot 稳定运行比啥都重要,问题是最不重要的。”这其实是一个典型的软件工程排序:先保证系统在关键时段工作,再讨论策略是否精巧。一个 99% 准确但偶尔完全失联的服务,实际效果可能不如一个只问“Rime 是什么?”却始终在线的简单 bot。
1. 验证题的本质,是成本不对称而不是智力考试
用 Elisp 表达式、异常栈或运行结果验证,看起来是在测试 Emacs 能力,实质是在提高 spam 自动化的单位成本。它不需要证明申请者是资深用户,只需要让批量注册、批量回复、批量营销变得不划算。反过来,群里也已经指出了风险:题目过难会把第一次听说 Emacs、只是想进来看看的人一起挡在门外。
因此,验证题不应追求“难倒模型”,而应追求“低成本真人可完成、批量 bot 不愿适配”。最好的问题可能不是复杂代码题,而是带有轻微社区语境、允许自然语言回答、并能快速人工复核的问题。验证失败也不必立即永久封禁,可以先限制发言、保留申诉入口,把误杀代价纳入设计。
2. 真正可维护的方案,必须承认系统会离线
关于“记录入群时间、事后删除未验证用户消息”的讨论,比实时审查更接近可靠系统设计:它把“当场拦截”改成“事件记录 + 延迟收敛”。这与 AI Agent 或个人知识系统中的任务处理很像——不能假设每个 worker 永远在线,而要保存足够的状态,让系统恢复后能够补偿处理。
私有 bot 的价值也正在这里:不是因为它能使用更强的模型,而是因为它可以围绕一个群的真实规模,保留入群记录、验证状态、消息时间线和审计日志。公开服务为了规模化往往只能提供通用能力;小范围系统反而可以把失败恢复、误杀申诉和历史清理做完整。
3. “用 AI 审查一切”可能是错误的抽象
群里有人提出让群友引用营销消息后再 @bot,这个方向值得重视。它把 bot 从“持续监听所有消息的裁判”变成“被触发的工具”,既减少资源消耗,也降低误判范围。AI 更适合处理被明确标记的可疑样本,而不是默认审查整个社区。对于低频但高损害事件,人工触发 + 自动分析,通常比全量实时扫描更容易验证、调试和控制成本。
可继续研究的方向:做一个最小私有 bot 原型,只实现“入群静默、简单验证、状态持久化、离线补偿、人工申诉”五件事;先连续运行一周,记录在线率、验证完成率、误杀率、漏放量和恢复后的补处理结果,再决定是否引入 AI。希奇的验证题可以后加,可靠的状态机才是系统的骨架。
Emacs 轻聊讨论组
🎯 核心热点与专题探讨
专题一:Emacs 生态的“去中心化”趋势与使用哲学
围绕 elfeed 作者 skeeto 推出不依赖 Emacs 的 elfeed2,群里展开了对 Emacs 使用哲学的深度讨论:
- 观点 A(轻量派):elfeed2 的诞生表明作者只是“轻度使用” Emacs,工具链并未被锁定在 Emacs 里。elfeed 对于原作者而言只是一个“中间工具”,用于过滤标题、判断内容是否值得深度阅读,最终阅读仍会回到原网页。
- 观点 B(纯粹派):部分群友表示“用 Emacs 只喜欢用来写代码,不喜欢集成工作流”,认为编辑器只是工具的一部分,不必将所有工作流打包进 Emacs。
- 观点 C(保守派):尝试 elfeed2 后仍觉得 elfeed 更好用,因为 elfeed2 的交互基于 XML 解析,且无法像 elfeed 那样深度自定义。
- 衍生讨论:提及 neomacs 的 GUI 测试进展,预计下下个版本在 macOS 上的表现会有显著进步。
专题二:AI 编程工具与 Token 经济
群里围绕 AI 编程助手、模型选择与 Token 成本展开了长时段讨论:
- Codex vs Claude Code:有人表示“看不惯 codex 写的代码,还真就不如 claude”,也有人提到“跟同事共用的 codex 20x 感觉完全够用了”。整体上,Coding 场景大家更认可 Claude(max/ultra)的代码质量。
- 模型选择:DeepSeek 4.1 flash 被认为是很好的执行模型,“常规代码很好用了,而且速度贼快”;Gemini 4 Pro 在多项基准测试中表现亮眼,尤其在三.js 3D 渲染与代码生成测试中“响应速度与生成质量均显著超越同类竞品”。
- Token 购买与计费:群友普遍反映 Token 购买是一大痛点——智谱的售后极差,“客服是AI的,通知是出了事只发一条的,补偿是只有一张两周后过期的重置卡的”;GLM 开票需要“用多少开多少”,且使用 banked reset 卡会导致本来重置延后一周。有人感叹“以前要研究代码,现在要研究的是 token 各种购买方法”。
- dsh vs pi 缓存差异:dsh 围绕 deepseek 设计,缓存命中率更高(约 99%),而 pi 缓存只有 89%,直连 API 计费花费会更高。
专题三:技能(Skill)工程化与 Agent 设计哲学
群友分享了一套关于“技能”体系的设计理念,获得了较高认同:
- 核心观点:技能是一种软件,需要按照工程的规范来组织。程序负责具体的功能,自然语言负责定义规则(即“程序就是约束,自然语言就是泛化”)。通过最小的操作原语和操作的组合来实现各种复杂功能,让模型通过简单的意图判断来选择命令或脚本。
- 实践方式:所有的技能都通过
pi-skill命令统一入口执行,参数化的脚本大大提高了执行的准确性,减少模型的思考负担。这样即使小模型也能准确执行。 - 争议点:关于“技能自进化”,有人认为没有对应的测试集,优化没有意义;也有人尝试让 AI 自己优化 Skills,结果“越改越拉胯”。微软开源的 SkillOpt(github.com/microsoft/SkillOpt)被提及,但群友对其如何解决该问题存疑。
🔑 关键概念与技术解析
- elfeed2:作者 skeeto 推出的不依赖 Emacs 的 RSS 阅读器。与 elfeed 不同,它通过
~/.config配置文件管理,交互基于 XML 解析。设计理念上更偏向“预览-判断-跳转原网页深度阅读”的中间工具。 - jj(Jujutsu):被南京大学老师蒋岩炎(jyy)在课堂上提到的“下一代版本管理工具”。核心优势在于“更细粒度的 commit,记录每一次的 change”,而 git 的 commit 太粗糙。群友评价“赶快用 jj,不然就成老登了”。
- LEFF.el:本地翻译 elisp 文档的工具,代码仅约 800 行,但 README 为俄文,导致部分群友“看不懂”。
- pi-intercom:Pi 的插件,支持直接向另一个 Pi 实例发送消息。群友认为有了它“不太需要 omp”了。
- AgentExecutor:被提及的工具,但群内讨论未深入。
- dsh(DeepSeek Helper):围绕 deepseek 设计的工具,其 tracing 部分做得特别好,显示的信息量足够多,方便调查模型到底被注入了什么东西。
- acp.el:底层协议相关,群友自建 UI 时使用,但“用起来卡卡的”。
💎 碎片知识与金句拾遗
- “以前要研究代码,现在要研究的是 token 各种购买方法。”
- “现在有钱人的酒窖里面放的不是红酒了,是自部署的 glm,恒温恒湿。”
- “每代模型都有自己的 ptsd”——指 GPT 太喜欢哈希值(sha256)。
- “基础知识决定了 ai 的使用上限”——讨论 AI 编程 debug 困难时总结:“AI 搓出来的代码 debug 就很难马上反应出来,之前手写的代码都能边走路边 debug,洗澡洗着灵感就来了。”
- “大模型的测试 fixture 是给模型自己看的,所以它根本不考虑人类可读”——解释 AI 生成的测试代码不美观的原因。
- Telegram 群消息被删后的恢复机制:超级群(supergroup)中,管理员封禁/移除成员时,Telegram 会将该成员在该群的历史消息一并清掉(Bot API 的
banChatMember里revoke_messages参数对 supergroup 强制为真)。一旦被删,服务端没有回收站。能捞回来的只有副本:别人引用/转发/截图过的发言、自己转发到收藏夹的备份、Telegram Desktop 本地缓存。 - .gitignore 的坑:设置
ignorecase = true后,Git 识别不到文件更改。群友表示“我被 ai 忽悠设置了这个选项,这个选项真的坑人”,并将此事写入个人文档。 - GitHub 仓库名不能包含
+号,URL 中需转义为%2B。 - 群友在开发红白机游戏 App(内嵌 NES 模拟器,优化操作方式);另一群友构想用手机扫描物体建模,给物体添加镭射效果,“物体是因为人的使用和主观感受才有的价值”,并提及 Meshroom、RealityCapture、Agisoft Metashape 等工具。
- 有人分享“vibe”了几个工具,“泛用性不强”,其中一个是自己写的 agent UI,底层走 acp.el。
- 群友在尝试开发手机输入法 App,完全支持小鹤音形 + 双拼按键,自用为主,不打算上架。
🛠️ 值得深入研究的点 (Follow-up)
- Skill 工程化实践:群友提出的“最小操作原语 + 自然语言定义规则”体系,以及通过
pi-skill统一命令入口的方式,值得深入研究。相关参考:微软开源的 SkillOpt。 - jj(Jujutsu)版本管理工具:jyy 的课程讲解(B站搜索“绿导师原谅你了”)提到了 jj 的优势,相关生态文章可参考 Beyond jj: config & tools ecosystem。
- dsh-emacs:群友开发的 Emacs 客户端,从视频 demo 来看很流畅(github.com/vritser/dsh-emacs),值得关注。
- AgentExecutor(agentexecutor.io):被推荐但未展开讨论,可进一步探索。
- 微软将 Copilot 运行时从 TypeScript 移植到 Rust:耗时 14.5 周、花费 12 万美元 token,性能提升 15.9 倍,内存占用从 1383 MB 降至 126 MB。这一案例展示了 AI 辅助的大型代码迁移可能性,值得追踪后续开源进展。
观点延伸
当天最值得咀嚼的判断,不是“哪个模型更强”,而是:当模型、工具和工作流都在快速变化时,真正应该稳定下来的,究竟是什么。
1. Skill 的核心不是提示词,而是可审计的执行边界
群里关于 Skill 工程化的讨论已经触及关键:程序负责约束,自然语言负责泛化;常用操作固化为最小原语,复杂流程通过组合完成。这实际上是在给 Agent 建立一层“可验证的操作系统”。
模型擅长理解意图,却不擅长稳定地重复执行细节。把“查日志、改配置、运行测试、读取结果”变成参数明确的命令,模型只需要完成意图分类和参数填充,错误空间就会显著缩小。这样做的价值不只是让小模型也能工作,更重要的是:每一步都能被人复现、替换和审查。
但 Skill 不能靠“让 AI 自己优化”获得可靠性。群里有人指出,没有测试集,优化就没有意义;“越改越拉胯”并不是偶然,而是自然语言规则缺少回归约束的必然结果。一个合格的 Skill 至少要有固定输入、预期输出、失败条件和若干反例。否则它只是会不断膨胀的说明文档,而不是软件。
2. Token 成本暴露了 Agent 架构的真实质量
当天关于套餐、缓存命中率、模型速度和订阅策略的争论,表面上是在比较供应商,实质上是在暴露工作流是否被设计好。一个 Agent 如果必须依赖最贵、最强的模型才能完成常规任务,说明大量确定性工作仍被交给了模型推理。
dsh 的高缓存命中率、足够详细的 tracing,以及群友提出的“确定化入口”,都指向同一个工程原则:减少重复上下文,缩短不必要的推理链,并让每次执行留下可解释的轨迹。模型能力当然重要,但系统质量最终取决于多少工作可以被脚本、缓存、测试和清晰接口接管。
这也解释了为什么“代码生成质量”不能只看一次输出。真正可持续的判断标准应是:同一任务能否稳定复现,失败后能否定位,换一个模型后能否继续运行,成本是否随规模线性增长。模型会换,套餐会改,缓存策略也会变;可迁移的操作边界和测试资产,才是个人工作流真正应该积累的东西。
可继续研究/实践
可以选一个高频 Skill,建立最小基准集:记录典型输入、预期行为、失败样例、执行成本和人工修复次数;再比较“纯自然语言调用”和“原语脚本加意图路由”的差异。不要先追求 Skill 自进化,先证明它能在一个月后仍然可靠。