
外观
Emacs 社区日报 2026-09-17
自动整理自 Telegram 讨论组,每天更新。内容为 AI 摘要,仅作信息索引与回顾。
Emacs 中文讨论组
🎯 核心热点与专题探讨
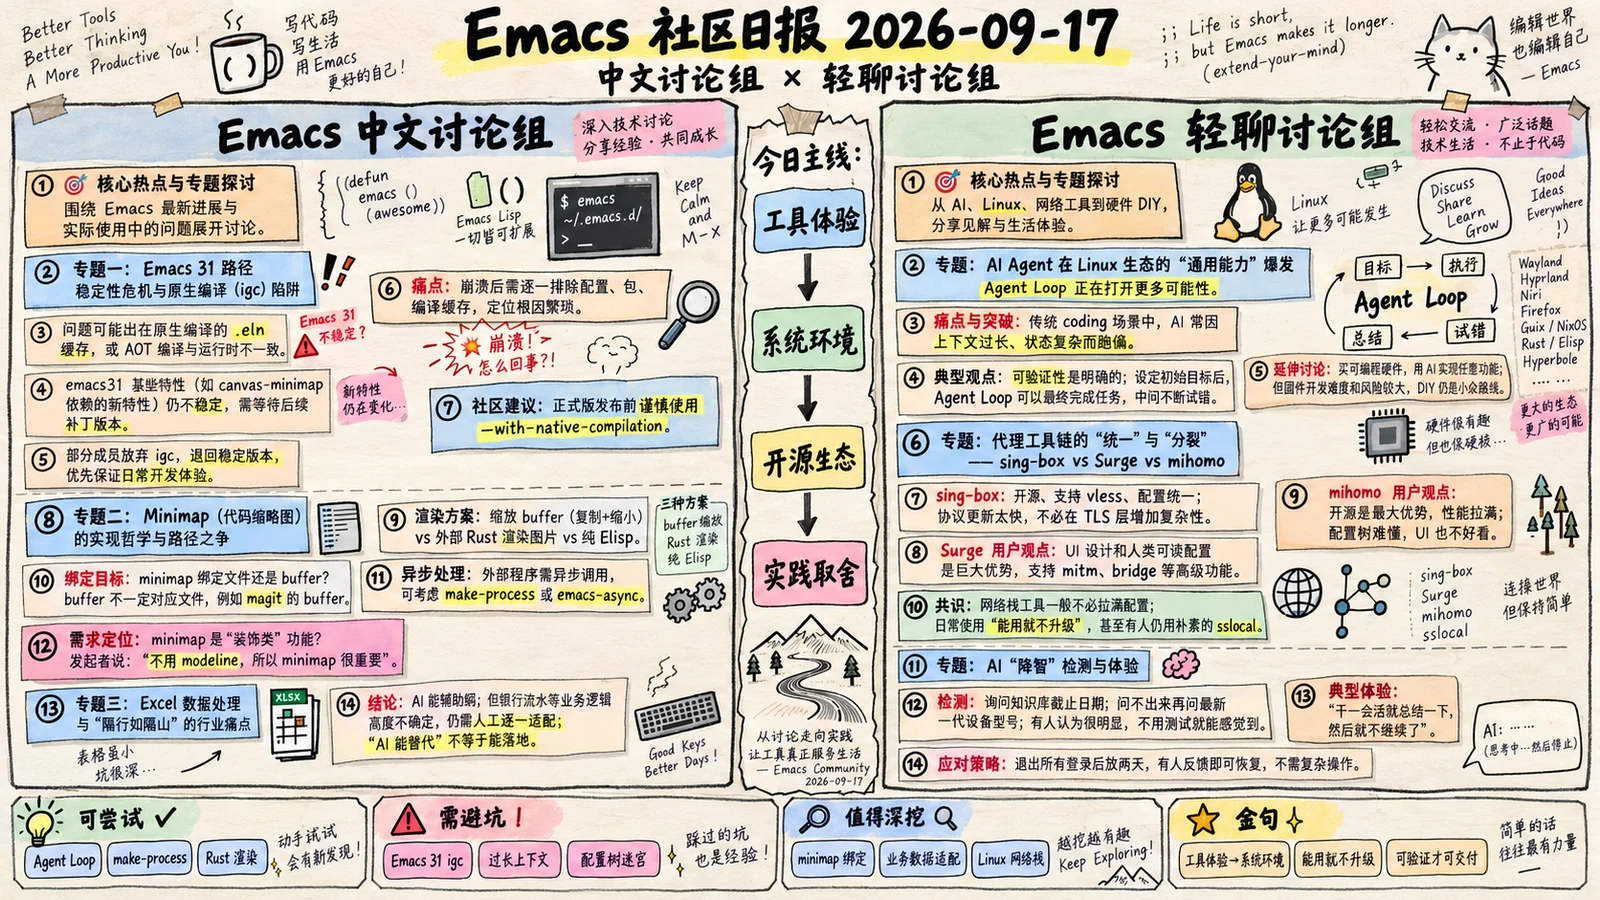
专题一:Emacs 31/32 稳定性危机与原生编译(igc)陷阱
群内围绕 Emacs 31/32 的崩溃问题展开了深入排查。有成员在启用 helm-mini 时遭遇致命错误(Fatal error 6: Aborted),经过最小配置重现后发现 helm-ls-git 是罪魁祸首,但即使排除后仍会崩溃,最终确认 minibuffer-frame 这一自定义包也可能触发相同问题。该成员尝试重新编译、切换至 emacs-31 分支后问题消失,但仍有人回归到 emacs 30.1,并吐槽“31 迫切需要 bugfix 版本”。更有甚者在 emacs32 下运行 minibuffer-frame 时直接崩溃,引发了关于原生编译(igc)稳定性的大讨论。
各方观点:
- 有人认为问题出在原生编译的
*.eln文件缓存或 AOT(ahead-of-time)编译与运行时的不一致。 - 有人指出 emacs31 的某些特性(如
canvas-minimap依赖的新特性)并不稳定,需要等待后续补丁版本(如 31.1 或 31.2)。 - 部分成员选择直接放弃 igc,退回稳定版本,以保证日常开发体验。
痛点与解决思路: 崩溃后需逐一排除配置、包、编译缓存,操作繁琐且难以定位根因。社区普遍建议在正式版发布前谨慎使用 --with-native-compilation=aot,并优先采用发行版官方源(如 Arch 官方仓库)以确保稳定性。
专题二:Minimap(代码缩略图)的实现哲学与路径之争
围绕 minimap 的实现方式,群内爆发了一场“Emacs 风格 vs 外部工具”的争论。传统方案(如 minimap.el、sublimity-map、demap)都是直接复制当前 buffer 并缩小字号,但存在锯齿模糊问题。有成员自研了 canvas-minimap,依赖 emacs 32 新特性,并坦言这是自己编写的第一个插件。另一位成员则提出使用外部程序(如 code-minimap,基于 Rust 渲染)生成 minimap 再展示,却被质疑“不够 Emacs 风格”。
核心争论点:
- 渲染方案:直接缩放 buffer(复制+缩小)vs 外部渲染(Rust 程序生成图片)vs 纯 Elisp 生成。
- 绑定目标:minimap 应绑定到文件还是 buffer?有成员指出 buffer 不一定对应文件,例如 magit 的 blob mode 或长 diff 视图。
- 异步处理:外部程序生成需要异步调用,有成员考虑用
make-process或emacs-async实现,但被提醒 Emacs 本身有make-thread可用。 - 需求定位:部分成员认为 minimap 是“装饰类”功能,应当禁用;而发起者表示“不用 modeline,所以 minimap 很有用”,并坚持将其作为个人配置来写,满足自身需求即可。
最终,有成员转向异步方案(async-shell-command)和 make-process 尝试解决更新阻塞问题,但整体仍处于探索阶段。
专题三:Excel 数据处理与“隔行如隔山”的行业痛点
凌晨时段,群内短暂但深入分享了银行流水导入系统的开发经历。成员自述为财务系统开发了 20 多个读取接口(每个对应一种银行流水格式),并面临银行导出格式频繁变动、财务人员不愿自行调整、老板对工作价值低估等问题。他认为 Excel 的核心并非格子,而是数据处理逻辑,并指出“数据库这玩意主要就是要减轻 excel 的依赖”。这一话题引发了对办公软件复杂度、XML 标准混乱(excelize 不支持旧 xls/csv)以及“AI 时代老板压价”的共鸣。
关键结论: 即使 AI 能辅助编码,业务逻辑的复杂度(如银行流水格式的“不确定”性)仍需要人工逐一适配;老板以“AI 能替代”为由压低报酬,导致开发者选择离开,回乡创业。
专题四:Emacs 31 的 vc 增强能否取代 magit?
白天时段,多位成员讨论到 Emacs 31 内置的 vc 功能已相当可用,可逐渐替代 magit。具体对比发现:vc 支持生成 patch、合并提交、创建 tag、cherry-pick(31 新增),但不支持 rebase,这成为多位重度用户继续依赖 magit 的理由。有成员询问“head-staging-worktree 三路 ediff 选择 stage 的”功能,vc 似乎也没有对应方案。
🔑 关键概念与技术解析
igc / native-compilation(原生编译):Emacs 通过 --with-native-compilation=aot 将 Elisp 编译为原生机器码(.eln 文件)以提升性能。但 emacs 31/32 在特定场景(如 minibuffer-frame 或 helm-ls-git 运行时)可能触发 Fatal error 6: Aborted,疑似与缓存、AOT 编译或树形 sitter 更新有关。
fido + minibuffer-frame:一种将 minibuffer 提升为独立浮窗(frame)的补全方案,通过自定义补丁提升编辑体验,但部分实现可能依赖 emacs 32 新特性,导致稳定性问题。
make-process 与 make-thread:Emacs 中异步执行任务的两种底层机制。make-process 通常用于启动外部 shell 命令,但群内讨论发现也可运行 Elisp 代码;make-thread 则是真正的多线程概念,对应操作系统线程。二者常被用于 minimap 更新、异步渲染等场景。
canvas-minimap:基于 emacs 32 新特性的 minimap 实现,不同于传统复制 buffer 再缩小的方案,而是通过外部程序生成 minimap 图并在 buffer 展示,但需处理异步更新与折叠状态的同步问题。
echo area 与 minibuffer:两者在同一位置,但 echo area 指“显示消息”的区域,minibuffer 则默认位于该位置,并承担交互输入功能。通过 frame 参数(如 minibuffer nil)可隐藏,但 buffer 级别无法隐藏,因为 minibuffer 是 frame 层级概念。
neomacs 的 wasm 构建:Neomacs 项目已支持构建为 WebAssembly 目标(experimental),底层选用 winit+wgpu 是为跨平台(如浏览器、桌面)设计。有成员评价“憋了个大的”,但主要工作还在后续。
💎 碎片知识与金句拾遗
- “Office 在以前可是万人团队级别项目”——回应 Excel 复杂度时,强调其背后工程规模远超表面所见。
- “所有企业的业务逻辑本质上均可通过 Excel 实现,现有数据库无法承载全要素的业务建模需求”——出自做 ERP 系统的成员,揭示 Excel 在业务建模中的独特地位。
- “AI 还会成为老板压价剥削的理由”——讨论 AI 对开发者价值的影响时,直言技术领导不懂时会以“有 AI”为由压低报酬。
- “我现在都不靠写代码挣钱了,回乡下和我舅舅创业,做饮食店,空闲时间就 vibe 一下感兴趣的项目,比上班自在”——个人选择脱离职场,追求自由。
- “Erase-buffer 也没有参数,哦,不用了,会自动覆写的”——清空指定 buffer 内容的快捷技巧。
- “inn 拉别人的服务还得策略慢一点,拉几百篇停一段时间,不然好像不太好”——维护 110 万条消息、8.5G 本地新闻库的经验,强调礼貌抓取策略。
- “在 Emacs 拿到第一件事就是干掉 tab-bar-mode、menu-bar-mode、scroll-bar-mode 和启动界面”——对 UI 洁癖者的共鸣,并延伸出“minibuffer 也很多余,想干掉”的呼声。
- “start-process 祇能運行 shell 命令嗎?我如何異步運行 elisp 函數呢?”——异步执行 Elisp 的常见困惑,后续被解答可用
make-process或make-thread。
🛠️ 值得深入研究的点 (Follow-up)
Emacs 31/32 原生编译崩溃的根因分析:当前已有复现步骤(
minibuffer-frame+helm-ls-git),可尝试用gdb附加崩溃 backtrace,定位到help-command-error-confusable-suggestions_0等原生 Lisp 函数是否与 igc 冲突。建议跟进 Emacs 官方 bug tracker 或 emacs-devel 邮件列表,观察 31.1/31.2 是否修复。minimap 的纯 Elisp 异步渲染方案:群内已提出用
make-process+ 回调或make-thread实现非阻塞更新,但尚未落地。可参考code-minimap(Rust 渲染)与canvas-minimap(emacs 32 新特性),尝试将外部程序替换为 Elisp 生成并异步刷新,同时解决折叠状态的 source of truth 问题。vc 补全 rebase 功能的替代方案:Emacs 31 的 vc 已支持多数 git 操作,但 rebase 仍是关键缺口。可关注
vc-rebase或相关分支,或探索magit的transient方案与vc的混合配置,以在减少依赖的同时补齐功能。neomacs 的 wasm 构建进展:Neomacs 支持 wasm 是“憋了个大的”前奏,其底层选择 winit+wgpu 的跨平台策略值得持续跟踪,尤其关注其如何将 Emacs 风格编辑体验带入浏览器。
minibuffer 隐藏的 frame vs buffer 层级设计:已有成员通过
dedicated frame实现隐藏,但 buffer 级别无法隐藏。可深入研究 Emacs C 层面对 minibuffer 的设计,探索是否可通过set-window-parameter或修改minibuffer-window属性实现更细粒度的控制。
观点延伸
当天最值得咀嚼的,不是“Emacs 31/32 到底稳不稳”,也不是“minimap 到底该不该存在”,而是同一个问题反复出现:一个功能究竟应该贴近系统的真实结构,还是先服务于使用者的局部体验。
1. 稳定性不是版本号问题,而是边界管理问题
minibuffer-frame 的最小复现、helm-ls-git 的触发、重新编译无效、换到 emacs-31 分支后消失,以及最后退回 Emacs 30.1,这条排查链说明了一件事:原生编译把“代码、构建产物、运行时环境”绑定得更紧,也让错误从 Elisp 层跨到了 C 和 .eln 层。此时“某个包能不能用”已经不是包本身的判断,而是版本、编译参数、缓存和调用路径共同组成的系统问题。
工程上,想使用新特性,就必须同时拥有回滚能力和最小复现能力。否则所谓尝鲜,实际是在把整个编辑环境变成不可审计的实验品。对 Emacs 这种高度可扩展的软件,稳定版本并不意味着功能少,而意味着故障边界更容易被观察和恢复。新版本真正成熟的标志,也不是功能列表变长,而是出问题时能明确回答:谁触发了崩溃、哪一层持有状态、怎样清理并复现。
2. minimap 的争论,本质是“显示投影”的架构选择
群里一方面嫌传统 minimap 缩放后模糊、锯齿明显,另一方面又质疑外部 Rust 程序“不够 Emacs”。这并不是审美争论,而是三种架构在竞争:复制 buffer 做视觉投影、从源文件生成静态图像、直接从当前 buffer 状态渲染。真正困难的地方不在画出缩略图,而在于它必须回答“当前内容是什么”。
一旦涉及折叠、未保存修改、长 diff、Magit blob 或非文件 buffer,文件就不能继续充当唯一数据源。minimap 若绑定文件,更新简单但语义错误;若绑定 buffer,又必须处理文本属性、窗口状态和异步更新。换言之,好的 minimap 不是把代码缩小,而是建立一个可失效、可重建的视图投影。个人配置可以只支持自己的使用场景,但一旦发布成插件,buffer 才应是默认抽象,文件只是其中一种来源。
可继续研究的方向,是做一个小型基准:分别测试同步复制、外部渲染和基于 buffer 的异步渲染,在修改频率、折叠状态、非文件 buffer 和大文件下记录延迟、CPU 占用与一致性。最终比较的不是“哪种更 Emacs”,而是哪种方案能用最小复杂度保持视图与编辑状态一致。
Emacs 轻聊讨论组
🎯 核心热点与专题探讨
专题:AI Agent 在 Linux 生态的“通用能力”爆发
群内多位成员围绕“AI 作为通用 Agent 在 Linux 环境中的能力”展开了深入讨论。核心观点是:Linux 生态的可验证性(命令执行必有明确返回结果)让 AI 的 Agent Loop 能够稳定收敛,最终达成目标。成员分享了使用 hermes、openclaw 等工具的体验,并认为 AI 在“任意主机上搞事情”、“完全掌控 Linux 生态”方面的能力已非常强。
- 痛点与突破:传统 coding 场景下 AI 常因上下文过长、状态复杂而“跑偏”(如群友反馈用 dsh 接 4.1 flash 经常跑偏),但在 Linux 命令执行场景中,AI 可以通过试错路径最终找到解决方案。
- 典型观点:“可验证性是明确的……只要你设定好一个初始的目标,Agent Loop 就可以最终把它给完成。中间可能会不断地试错,去探索很多条路,但最终总是能找到一个方案给它做完。但是 coding 要考虑的事情就要多很多。”
- 延伸讨论:有成员提出“买一个可编程的硬件,用 AI 来实现任意的功能”,但被指出固件开发难度和风险较大,DIY 仍是小众路线。
专题:代理工具链的“统一”与“分裂”——sing-box vs. Surge vs. mihomo
围绕代理工具的讨论从下午持续到晚上,核心焦点是 sing-box 的“统一新栈”是否值得迁移。
- sing-box 的吸引力:开源、支持 vless、配置统一、作者认为协议更新换代太快,在 TLS 层增加复杂性不合适。
- Surge 的忠实用户反驳:Surge 的 UI 设计和人类可读配置仍是巨大优势,且支持 mitm、bridge 等高级功能;商业软件与开源软件很难简单比较。
- mihomo/Clash 用户的观点:开源就是最大优势,但性能拉满;有人吐槽 mihomo 的配置树都“整不明白”,UI 也不好看。
- 共识:网络栈这类工具,一般用户不需要拉满配置,日常使用“能用就不升级”。有人甚至还在用最朴素的
sslocal。
专题:AI“降智”检测与体验
深夜时段,群友开始讨论如何检测高端模型是否被“降智”(可能指模型在高峰期被降级为较弱版本)。
- 检测方法:通过询问“知识库截止日期”,能问出来说明被降智;问不出来就询问最新一代设备型号。但有人认为“很明显,都不用测试就能感受到”。
- 典型体验:“干一会活就总结一下,然后就不继续了”——这是被降智后的典型表现。
- 应对策略:有人分享自己的账号“退出所有登录后放两天”就恢复了,不需要复杂操作。
🔑 关键概念与技术解析
- Dagu / ordewell:两种“自动任务编排器”,用于调度自动化工作流。群友对比后认为两者风格不同,Dagu 更偏向自动化采集流程。
- OpenCLI:一个开源项目,用于自动阅读爬取 X 平台列表内容,作为信息源狩猎机器的一部分。
- NotebookLM Source Pack:Google 的 NotebookLM 功能,可将多个来源打包综合分析,群友用它生成信息报告。
- typedartifact:AI 编码工具(如 codex)中可编辑的中间产物格式,群友吐槽 ordewell 无法中断任务并修改 typedartifact。
- dwm combo:dwm 窗口管理器支持在一个屏幕直接显示多个工作区(如 1+2),无需像 niri 那样把窗口挪到附近。群友评价这是“滚动桌面更高级的设计”。
- 6DoF / 眼动追踪:六自由度空间定位,群友在 DIY VR 桌面时提到“6DoF 能正常工作了”,并计划用眼动替代鼠标实现注视点渲染。
- DGX Spark:NVIDIA 的桌面级 AI 工作站,群友讨论其内存能否跑满血模型(约需 7 万多成本)。
- AI 降智:指模型在高峰时段被降级为较弱版本,可通过“知识库截止日期”测试检测。
💎 碎片知识与金句拾遗
- “信任仁慈的机器是 Agents 自动化时代的第一课。” —— 来自信息源狩猎机器分享者。
- “我觉得 AI 之所以在通用 Agent 的能力上比较强的原因,就是它的可验证性是明确的。” —— 讨论 AI 在 Linux 生态的优势时。
- “coding 还是一坨” —— 对 AI 编码能力的吐槽。
- “语音控制适合输入,不适合修改” —— 讨论语音交互的局限性。
- “脑机接口才适合快速输入” —— 对语音输入局限的调侃。
- “炒作之神,拿到这个奖的允许喊妈妈” —— 对某个奖项的讽刺。
- “中国人多” —— 解释为何某个插件生态数量爆炸。
- “一大堆垃圾前端插件...改个字都能当成插件发上来” —— 吐槽插件生态的良莠不齐。
- “你还得挖个坑,不然掉下来人就凉了” —— 讨论行车安全时的经验之谈,涉及龙门架、加气块车库等具体细节。
- “我有朋友哥哥就是在悦达起亚,砸死的” —— 行车安全事故的实例。
- “只要能用就从不升级” —— 对代理工具链的实用主义态度。
- “我现在维护在 worker,有改动就让 AI 弄” —— 用 AI 维护代理配置的实践。
🛠️ 值得深入研究的点 (Follow-up)
- 信息源狩猎机器工作流:分享者用 Dagu + OpenCLI + NotebookLM + Notion API 构建的 24 小时自动化信息采集系统,值得深入研究其具体配置和 Source Pack 用法。
- AI 通用 Agent 在 Linux 生态的应用:成员提到
hermes、openclaw等工具,以及“AI 任意主机上搞事情”的潜力,值得关注这些工具的开发状态和案例。 - DIY VR 桌面:群友正在逆向 VR 头显,实现 6DoF 和眼动追踪,计划自建 VR 下的 Wayland compositor,极具极客精神,值得持续关注。
- dwm combo 设计:dwm 支持任意 workspace 组合显示,被认为是滚动桌面更高级的设计,值得对比 niri 的滚动机制深入研究。
- DeepSeek 上下文丢失问题:群友反馈 DeepSeek 在思考时产生幻觉导致结果错误,疑似上下文过长导致 lost in middle,值得测试不同模型的上下文管理能力。
观点延伸
当天最值得咀嚼的判断,不是“AI 能不能写代码”,而是:AI 已经更适合处理那些有明确反馈回路、允许试错、结果能够被机器验证的任务。Linux 主机上的命令执行正符合这个条件:命令有退出状态,文件有内容差异,服务有日志,端口有响应。Agent 即使中间走弯路,也能根据反馈修正路径。相较之下,编码不仅要让程序运行,还要满足隐含需求、兼容既有结构、保持可维护性,并避免改坏没有被测试覆盖的部分。因此,“通用 Agent 很强、coding 仍然一坨”并不矛盾,二者面对的是不同难度的反馈系统。
1. 真正的能力边界在验证,不在模型聪明程度
这也解释了当天关于硬件、VR 逆向和 Linux 自动化的讨论。只要设备能提供稳定接口、日志或可重复的状态变化,AI 就可能逐步接管调试流程;但固件刷坏后无法重新写入、硬件内部资料缺失,就会让反馈回路突然中断。工程上,AI 可控性的上限不是“模型是否懂所有知识”,而是系统能否提供安全、细粒度、可回滚的验证接口。给设备加调试口、模拟器、恢复模式,可能比换一个更大的模型更有价值。
2. 信息自动化的核心不是吞吐,而是状态管理
信息源狩猎机器已经证明,采集、去重、总结、发布可以高度自动化;但群里也指出了连续事件重复报道、历史认知如何继承等问题。这里的难点不是再接入更多 RSS 或 X 列表,而是维护“事件状态”:哪些内容是新事实,哪些只是旧事件的新表述,哪些判断已经被推翻。没有状态管理的自动摘要,只会把信息洪水压缩成更高密度的洪水。个人知识系统真正需要的不是更多报告,而是可追踪的事件、证据和判断变化。
3. “统一工具链”不等于“更好的使用体验”
sing-box、Surge、mihomo 的争论同样说明,工程上的统一通常只解决协议和配置的一致性,却不自动解决可理解性、可操作性和升级成本。一个工具是否值得迁移,不应只看支持多少协议,而应看配置能否被人读懂、变更能否快速验证、升级失败能否恢复。让 AI 代维护配置,前提仍然是配置结构清晰、差异可审查、回滚足够便宜;否则只是把复杂性从人脑转移到 Agent 的黑箱里。
可继续研究/实践
可以做一个小型对照实验:用同一 Agent 分别处理 Linux 服务故障、代码修改和持续事件摘要,记录每一步的反馈信号、失败类型、人工介入点与回滚成本。比较结果大概率会表明,提升 Agent 可靠性的第一优先级不是增加提示词,而是把任务改造成“可观察、可验证、可回滚”的系统。