
外观
Emacs 社区日报 2026-09-15
自动整理自 Telegram 讨论组,每天更新。内容为 AI 摘要,仅作信息索引与回顾。
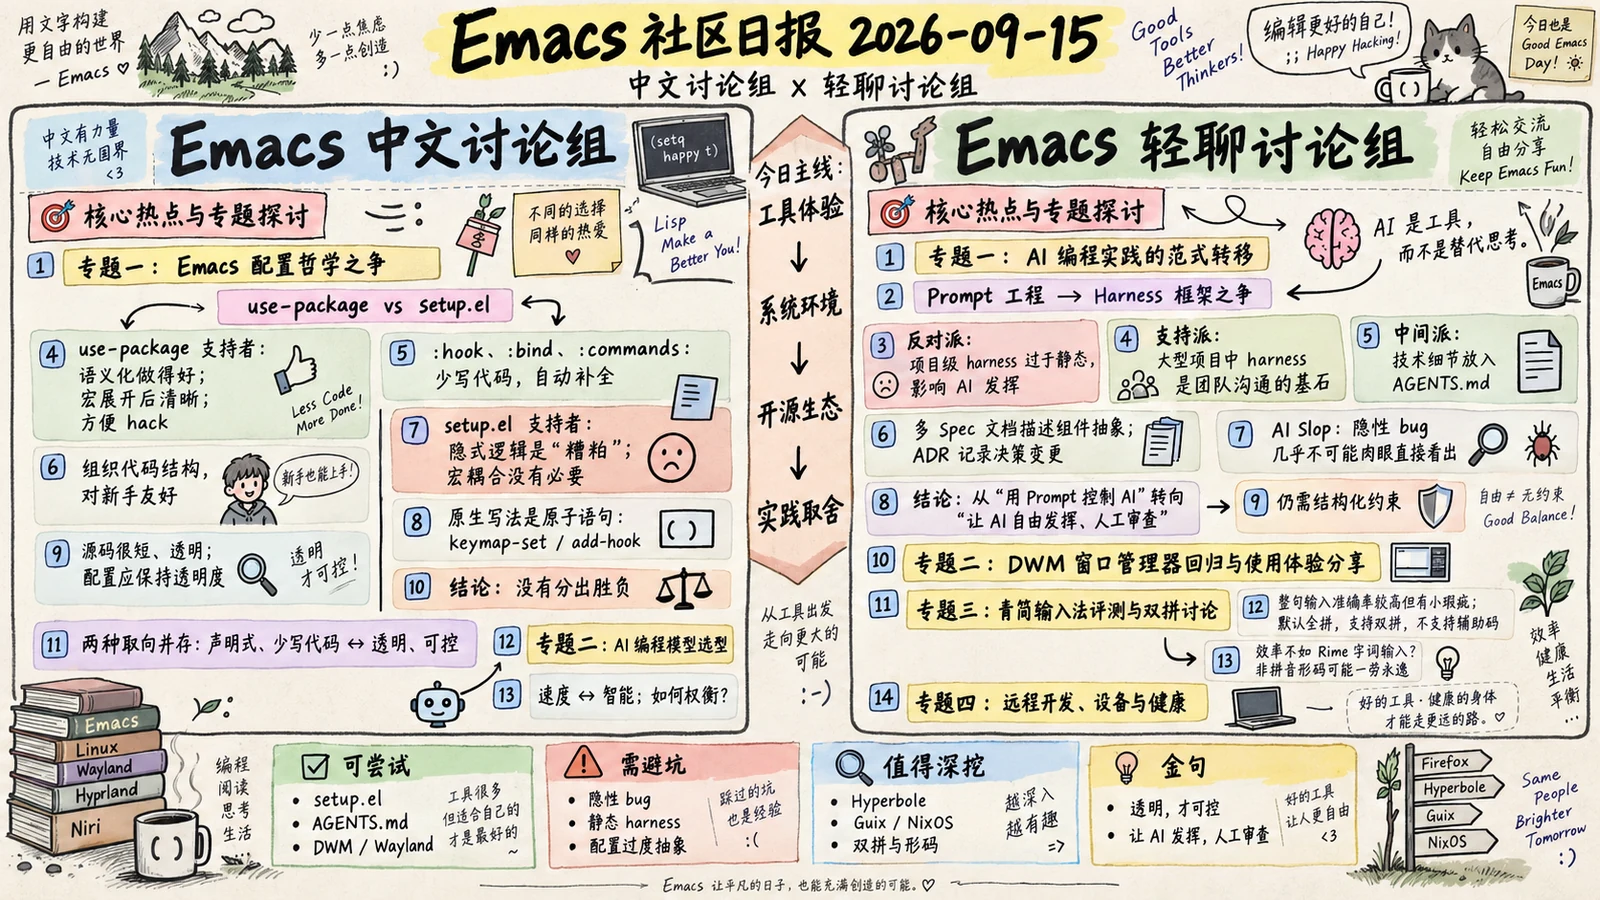
Emacs 中文讨论组
🎯 核心热点与专题探讨
专题一:Emacs 配置哲学之争 —— use-package vs setup.el
本次讨论的核心焦点是 Emacs 配置方案的取舍。群友围绕 use-package 和 setup.el 展开了激烈的辩论,反映了配置工具设计哲学上的两种截然不同的取向。
use-package 支持者观点:
- 语义化做得好,宏展开后很清晰,方便 hack
:hook、:bind、:commands等字段能少写很多代码,自动补全(如:hook prog-mode自动推断出indent-bars-mode)- 方便组织代码结构,对新手友好——避免了手动
require+setq的繁琐
setup.el 支持者观点:
use-package的隐式逻辑(如自动补全)是"糟粕",宏带来的耦合是"没有必要的"- 原生写法如
(keymap-set keymap key def)、(add-hook hook fun)本身就是原子语句,组合成(:bind ...)只是增加了不必要的抽象层 setup.el源码很短、透明,没有什么复杂的宏,简单明了- 配置应当保持透明度,即便啰嗦也应当可读
核心痛点与解决方案: 讨论中暴露出一个关键矛盾:"少写字符" 与 "保持透明度" 之间的张力。支持 use-package 的群友坦言"想偷懒少写几个字符出问题了那我就扛着",而反对者则认为"字符多几个少几个无关紧要,但没有必要的耦合我一般都想避免"。
此外,讨论还触及了一个更深层的问题:新手学习曲线。有群友分享自己的经历:"我新手的时候就是一个文件里面 require 包进来然后用 setq 一个一个设置选项",而 use-package 的 :custom、:config 恰好解决了这个问题。但 setup.el 的推崇者反驳说,这种"方便"是以牺牲代码透明性为代价的。
结论: 这场讨论没有分出胜负,但揭示了 Emacs 配置生态中两种并存的取向:追求"声明式、少写代码"的 use-package 派,和追求"原子式、透明可读"的原生写法派。值得注意的是,多位群友表示自己已从 use-package 迁移到 setup.el 或原生写法。
专题二:AI 编程模型选型 —— 速度与智能的权衡
群友在讨论 AI 编程辅助时,对比了多个模型:DeepSeek 4.1 Flash、Kimi K3、GLM 5.3 Flash、Qwen 3.7 Flash 等。
关键观察:
- DeepSeek 4.1 Flash:输出速度极快(官方 300 token/s),但"废话太多",需要搭配人工 review
- GLM 5.3 Flash:单位自运行约 70-80 TPS,5.3 本体 40-50 TPS,但不支持多模态,"太笨了,转不动"
- Kimi K3:被推荐为"下一代模型"候选,但 K3.1 价格昂贵且套餐未开售
- 模型选型的核心标准:有群友直言"4.1 快,尤其官方的 300token/s",即使模型啰唆也被输出速度掩盖掉了;但也有群友认为"小模型还是不适合和人类交流"
关于 DeepSeek 极简模式的传闻: 有群友提到"deepseek 4.1f 搭配 dsh 极简模式很强",并称极简模式"有 Astra 的味道"。但随后有人质疑消息真实性,提到 "lwf 知道这个事情吗",最终结论偏向"假消息"。不过 κόσμος 的调侃倒是道出了 Astra 的味道:"一小时跑完 1 周额度、代码雷霆压行"——极简模式工具最少,自然输出更快。
🔑 关键概念与技术解析
setup.el:一个 Emacs 配置库,由 pkal 开发,旨在用更透明、更简单的宏替代 use-package。它的设计哲学是减少隐式逻辑,保持配置代码的原子性和可读性。仓库地址已从 sr.ht 迁移至 Codeberg(https://codeberg.org/pkal/setup.el)。
use-package 的隐式补全:在使用 (use-package indent-bars :hook prog-mode) 时,宏会自动将 prog-mode 补全为 prog-mode-hook,并将当前包名 indent-bars 补全为 indent-bars-mode。这是一种"隐式逻辑",虽然方便,但增加了宏的复杂性,且包名与 mode 名不一致时会出问题。
MDX 词典格式:一种非标准的电子词典格式,通常包含词条、释义、音标等数据。群友提到"mdx 格式和其他格式一样,都不是严格的标准格式,有各种非标的操作",因此在转换时需要针对性地编写脚本适配。
/btw 与 /side 命令(OpenAI Codex):根据代码分析(https://github.com/openai/codex/blob/main/codex-rs/tui/src/chatwidget/slash_dispatch.rs#L339),/btw 实际上是"临时对话"而非真正的 fork,不会保存到主对话 session。与 /fork 的区别在于 fork 有参数可以选择是否携带上下文(参考 agent v2 的 spawn.rs 实现)。
💎 碎片知识与金句拾遗
关于配置哲学的吐槽:"use-package 就是典型的没有必要的耦合" —— 这句话概括了反对派的核心立场。
关于审美被 Emacs 改变的感悟:"我的观念也被 emacs 给转改了,我的审美也是" —— 使用 Emacs 久了,连代码风格和审美偏好都会受影响。
setq 风格的个性化表达:"我喜欢一个一个 setq,就像写 js 一样一个一个 var" —— 用 JS 的
var来类比 Emacs 配置,生动有趣。关于 AI 对话场景的判断:"我感觉 ai 对 ai 讲话还是清晰一些,人对 ai 的话需要一个理解能力强的" —— 这解释了为什么 flash 小模型适合做 subagent 而非直接与人对话。
关于模型速度的无奈:"它再啰唆也被这个输出速度掩盖掉了" —— 300 token/s 的输出速度足以掩盖模型质量上的不足,这种取舍很现实。
关于 GLM 的使用场景:"GLM 我都是半夜挂着用的,他本身输出速度就没那么快,思考又要绕弯" —— 慢速模型适合无人值守的批处理任务。
关于 AI review 代码的态度:"我平时的工作没有那么高端,所以够用。然后我会人工 review 代码,不行的地方就手动改,最差的情况就是古法编程一遍。" —— 务实主义的 AI 协作方式。
Codex 中
/btw的本质:"没有,它其实不是 fork,它是临时对话" —— 技术细节的澄清,很多人误以为btw是 fork 的一种。
🛠️ 值得深入研究的点 (Follow-up)
setup.el及作者配置体系:仓库已迁移到 Codeberg(https://codeberg.org/pkal/setup.el),作者的配置及理由(https://ruzkuku.com/texts/emacs-conf.html)提供了完整的思路参考。群友分享的配置列表(Elilif 的.emacs、nasy 的配置、Lewisliu 的 nowisemacs)可以作为学习setup.el的实践案例。lexdb—— MDX 词典转 SQLite 的解决方案:由 Lucius_Chen 开发(https://github.com/LuciusChen/lexdb),通过脚本将非标准的 MDX 格式解析为 SQLite 数据库,支持在 Emacs 中查词。如果遇到新的 MDX 词典,可以参考仓库中的脚本编写适配器。OpenAI Codex 的
/btw与/fork的实现差异:代码链接提供了确切的实现细节(slash_dispatch.rs 和 spawn.rs),深入研读可以理解临时对话与 fork 在设计上的区别,以及如何用/fork的参数控制上下文继承。DeepSeek 4.1 Flash + dsh 极简模式:虽被群友质疑为"假消息",但"极简模式工具最少"的设定值得研究——减少工具数量是否确实能提升模型输出效率和准确度?这一方向可能与 Agent 工具设计的"少即是多"理念有关。
观点延伸
当天最值得咀嚼的,不是 use-package 和 setup.el 谁“更好”,而是一个更普遍的工程判断:抽象的价值不在于少写多少字符,而在于它是否稳定地压缩了认知成本。
1. 配置抽象的边界:省略语法,不能省略因果
群里对 :hook prog-mode 的争论,表面上是写法偏好,实质上是“谁负责理解隐含规则”。use-package 把包名、命令名、模式名之间的关系包装起来,初学者因此更快得到可用配置;但一旦命名不一致、需要 lambda、或者发生加载时序问题,原本被隐藏的因果链就必须重新找回来。
所以透明度不是“代码越原始越好”,而是关键行为能否被快速定位、展开和验证。宏并非天然有害,真正危险的是:抽象规则无法从局部代码推断,展开结果又不容易查看。一个实用标准是,配置出现问题时,能否在几分钟内回答三件事:最终执行了什么、何时执行、依赖了谁。macroexpand、最小复现配置和明确的原子调用,都是降低这类调试成本的手段。
这也解释了为什么有人会从 use-package 迁移到 setup.el:不是拒绝抽象,而是希望把抽象限制在可审计范围内。配置系统本身也应像生产代码一样,优先减少隐式耦合,而不是盲目追求声明式的漂亮。
2. AI Agent 的模型选择:速度只有进入反馈回路才有价值
群里“模型差不多就选最快的”并不浅薄,它成立的前提是任务可以被快速切分、快速执行,并由人持续 review。对简单修改、批量试错、subagent 或无人值守任务,300 token/s 可能确实比更聪明但更慢的模型更有生产力:等待时间下降,反馈次数上升,人工纠错也能吸收部分质量差异。
但这套判断不能直接推广到人机协作的所有环节。小模型“对 AI 说话更清晰”,恰好说明它适合结构化委派,却未必适合处理含糊需求、跨文件约束和高风险决策。速度快还会放大错误吞吐:如果缺少测试、边界检查和人工验收,模型只是更快地产生更多需要返工的代码。
因此,模型选型应按反馈回路分层:人直接对话的入口优先理解力和多模态能力;可验证的子任务优先速度与成本;最终合并前必须由测试和 review 接管。所谓“极简模式”是否有效,也不该靠传闻判断,而应比较相同任务下的工具调用次数、首次成功率、返工时间和最终修改量。
可继续实践的方向是:为 Emacs 配置和 Agent 编程各做一组最小基准。前者记录宏展开、启动时序与故障定位时间;后者记录同一任务在不同模型、工具集和提示结构下的成功率与人工修复成本。最终比较的不是代码短不短、输出快不快,而是从意图到可靠结果的总路径是否变短。
Emacs 轻聊讨论组
🎯 核心热点与专题探讨
专题一:AI 编程实践的范式转移——从 Prompt 工程到 Harness 框架之争
今天的讨论围绕 AI 编程工具链展开了一场深度辩论。核心矛盾点是:在强模型(如 Astra、Fable)出现后,传统的 Prompt 工程和 Harness 框架是否还有必要。
各方观点:
- Harness 反对派:群友
WD明确表示对项目级 harness 的排斥,"过于静态了 影响ai发挥"。其核心论点是:强模型(Astra、Fable)已经拥有足够的注意力和编程能力,不再需要额外的 Spec 引导,反而 Spec 的维护成了"沉重的负担"。他封存了spec-agents项目,认为对强模型来说,保持上下文的纯净、确保 Prompt 不前后反复,比使用框架效果更好。 - Harness 支持派:另一部分群友认为 harness 在多人协作的大型项目中仍是"团队沟通的基石"。在没有 spec 的情况下,代码规模超过 10 万行时沟通会变得困难,"口述不完整,容易漏"。
- 中间派:有人提出折中方案——将技术细节放入
AGENTS.md,用多 Spec 文档描述组件抽象,并用 ADR 文档记录决策变更。但同时指出,"AGENTS.md 是最应该手写的东西",AI 生成的文档需要人工 review。 - AI Slop 的讨论:群友
sutsevni认为 AI 生成代码最大的问题在于"隐性 bug 几乎不可能肉眼直接看出来",尤其是死循环这类问题。且 AI 是随机模型,"交互越多,偏差越大",因此推荐使用oneshot模式——一次性生成完整方案,不对就重来。这一观点得到多人支持。
结论:这场讨论揭示了 AI 编程工具演进的趋势——从"用 Prompt 控制 AI"转向"让 AI 自由发挥、人工审查"。但所有人都认同:AI 生成代码无法人工审查的问题依然严峻,特别是代码规模膨胀到几十万行后,"ai slop 是沒有辦法維護的,放棄就行了"。
专题二:DWM 窗口管理器回归与使用体验分享
凌晨的讨论围绕 dwm 展开,多位群友分享了使用体验。核心痛点集中在 HiDPI 支持——在 X11 环境下,高分屏显示效果不佳。有群友表示"X1 carbon 就還是用的 sway,有 HiDPI 就得 sway"。但大多数参与者认为 dwm 的价值在于"自己編譯改配置才好玩",打补丁、维护配置的过程本身就有乐趣。有人推荐 status2d 补丁美化状态栏,但另一部分人表示"只要必要的信息顯示了就好",追求极简。整体氛围是"dwm,起飞",对复古工具的怀旧与赞赏。
专题三:青简输入法评测与双拼讨论
群友分享了国产开源输入法「青简」,并进行了实际测试。主要发现:
- 整句输入的准确率较高,但体验"还有小瑕疵";
- 默认使用全拼,支持双拼但不支持辅助码;
- 有人表示"整体输入的效率来说,还是不如我直接用 rime 以字词的方式输入",原因在于整句输入的准确率不确定,导致用户需要反复 check,增加心智负担;
- 有人提出非拼音输入法(如形码)"一勞永逸"的观点,获得认同。
这一话题与开发者对 AI 辅助编码的讨论形成了有趣的对照——都是关于"工具是否值得信任"的问题。
专题四:远程开发、设备与健康
群聊中穿插了多个生活与工具话题:AR/VR 眼镜写代码的可行性探讨(有人推荐 Goovis 产品)、屏幕护眼经验(墨水屏、黑白灰模式、屏幕灯、自然光屏幕)、键盘布局(Glove80 拇指区设计)、以及经济形势的讨论。有群友分享了一位 36 岁脑干出血的病例,提醒大家注意作息与健康。
🔑 关键概念与技术解析
- DWM:一个极简的 X11 窗口管理器,以 C 语言编写,需要通过编译补丁进行配置修改,深受 Arch Linux 用户喜爱。今天讨论中强调了它的"可定制性"与"HiDPI 短板"。
- HiDPI:高分屏适配问题。在 X11 环境下,dwm 等工具对高分屏的支持不佳,这是用户转向 Wayland/Sway 的主要原因。
- Devspace:一种将本地目录安全接入网页版 ChatGPT 进行开发的方式,使 ChatGPT 可以直接操作本地代码仓库。有人提到它不需要 tunnel-client(OpenAI 自有的隧道客户端),也有人尝试用 tailscale 替代。
- Harness(或 Agent Harness):一套用于编排 AI Agent 的框架,通常包含项目级配置、任务分解、工具调用等机制。今天讨论了它在强模型场景下的必要性。
- AGENTS.md:一种让 AI Agent 理解项目约定的配置文件。有群友强调它"最应该手写",是 AI 开发流程中的重要文档。
- ADR(Architecture Decision Records):架构决策记录,用于追踪项目中的技术决策变更,常与 Spec 文档配合使用。
- AI Slop:指 AI 生成的低质量、难以维护的代码。群友认为这是 AI 编程的核心风险之一。
- Monorepo:单一代码仓库管理多个项目/子项目。今天讨论认为它适合 Devspace 等 AI 开发方式,也适合 jj(Jujutsu)等版本控制工具。
- Jujutsu (jj):一个现代版本控制工具,兼容 Git 但提供更友好的操作。有群友分享了围绕 jj 的"嵌套 monorepo"工作流。
- Submodule/Subproject:指在一个仓库中嵌入多个子项目,今天讨论中有人提到"发明一个新的 submodule"。
- Spec-Agents:一个基于 Spec 文档的 AI 开发框架,今天被作者封存,理由是强模型不再需要 Spec 引导。
- DSH / Zcode:可能指 DeepSeek Harness 和某缓存方案,用于降低 AI API 调用成本,通过缓存提高命中率。
- Rime:一个开源输入法引擎,支持自定义方案,被群友认为在整句输入效率上优于 AI 输入法。
- Magit:Emacs 的 Git 界面,今天有人抱怨其响应速度慢。
- Citre:Emacs 中基于 ctags 的 C/C++ 补全工具,今天被推荐为 LSP 的轻量替代方案。
- Dumb-jump:Emacs 中的快速跳转工具,精度略逊于 LSP 但无需启动额外进程。
- OpenCode Go:一个开源 AI 编程 CLI 工具,今天有人对比了它的价格与 Cline Pass。
- Firstmate:可能指一个 AI 编程工具,今天有人在寻找其 token 配额。
- Multica / Herdr / Bub / Pi:这些可能是群友正在开发或使用的 AI 编排工具。今天讨论了它们的 session 抽象、缓存命中率等问题。
- Majutsu 适配:可能指某个编辑器或工具与某 AI 工作流的集成。
- Neomacs:一个开源项目,目标是让 Emacs 的 package 能在浏览器中运行。今天版本更新到了 0.0.18。
- Tailscale / Moonlight / Sunshine:远程访问/串流工具组合,用于远程桌面或游戏串流,今天有人提到了这种工作流。
- UU 远程:网易出品的远程控制工具,支持串流方式远程操作,但无 Linux 支持。
- Kinesis / Glove80:分体式人体工学键盘品牌,今天讨论了大拇指区域的按键布局问题。
- Bitter Lesson:一篇 AI 领域经典文章,强调通用计算方法胜过人类知识注入。今天讨论中引用它来说明"不应过早经过人类知识的污染"。
- Rerank 模型:一种用于优化检索排序的 AI 模型,今天提到青简输入法使用了 50MB 的 rerank 模型,效果显著。
💎 碎片知识与金句拾遗
- "dwm似乎让我回到10年前了😅" —— 对复古工具的感慨。
- "找补丁维护。折腾起来是挺开心的" —— 对 dwm 补丁文化的认同。
- "就是x11的hidpi是真的难蚌" —— 对 X11 HiDPI 的无奈。
- "墨水屏是护眼的唯一真神" —— 护眼话题下的总结。
- "美学是一个需要和代码一起被考虑的东西,甚至比代码更加重要" —— 对界面美学的观点。
- "AI 最大的問題是從 input -> output 這個過程中有隨機性... 交互越多,偏差越大" —— 对 AI 迭代生成代码的批判。
- "代码永远比需求多,需求永远比业务多" —— 对软件开发成本的洞察。
- "AI slop 是沒有辦法維護的,放棄就行了" —— 对 AI 生成代码的悲观看法。
- "如果企業開發,最後的成本來源,ai 出現之前,就從來不是寫代碼。而是 CI/CD 的流程成本,環境的運維成本,需求和約束的研討的成本,寫代碼從來都不是痛點。" —— 对软件开发成本的重新审视。
- "最合理的方案还是语音输入" —— 讨论 AR 眼镜写代码时的建议。
- "把电子烟和语音输入做一起" —— 对语音输入设备的调侃。
- "现在 AI 的刀耕火种时代" —— 对 AI 发展阶段的判断。
- "前有 Anthropic 和 OpenAI 抬高 AI 的上限,后有 DeepSeek 梁圣做普惠智能... 刀耕火种时代也很快结束了" —— 对 AI 未来的乐观展望。
- "我不信任 Anthropic 或者 OpenAI 能这样做... 我们研究强大、快速、普惠的人工智能并将其开源" —— 引用自某篇关于 DeepSeek 的文章。
- "加速主义者其实不够加速..." —— 对加速主义观点的嘲讽。
- "我几乎就没有晚上睡过,但是我小时数足够" —— 某群友分享自己的作息习惯。
- "单拇指 layout,如果分体就一边各一个" —— 对键盘布局的个人解决方案。
- "训练的只用英文思考吧,这样子可以降低算力的要求" —— 对 DeepSeek 中文思考能力的猜测。
- "TS 是个很烂的語言" —— 对 TypeScript 的吐槽。
- "我认为ts拯救了js" —— 对 TypeScript 的辩护。
- "这类动态语言的问题,都是只能局限于1w行左右的代码,问题就马上出现了" —— 对动态语言的批判。
- "我基本不配了" —— 指现在 AI 时代不再配置 LSP。
- "最重要的是跳转" —— 关于 LSP 的主要用途。
- "用了 ctags+citre 那套" —— 推荐 LSP 的轻量替代方案。
- "看编译速度,ts 一直以来编译速度不是很理想" —— 对 TypeScript 编译速度的批评。
🛠️ 值得深入研究的点 (Follow-up)
- 青简输入法(https://github.com/qingjian-team/qingjian):国产开源输入法,使用 50MB 的 rerank 模型实现高准确率的整句输入。值得关注其后续发展,特别是双拼与辅助码支持。
- Neomacs(https://github.com/eval-exec/neomacs):让 Emacs package 能在浏览器中运行的项目,目前版本已到 0.0.18。对 Emacs 用户来说是一个潜在的前端革命方向。
- jj-forklift(https://github.com/rivet-dev/jj-forklift):围绕 Jujutsu 的工作流工具,支持嵌套 monorepo 操作,值得进一步探索。
- zashboard(https://github.com/Zephyruso/zashboard):sing-box 的 Web 面板,近期发布了远程面板功能。作者对 sing-box 项目表达了不满,值得关注社区后续动态。
- Spec-Agents 封存原因(https://www.gtdstudy.com/):作者分享了封存原因,对理解 AI 编程框架的演化有参考价值。
- Goovis G3 Max(https://www.goovis.com/products/goovis-g3max):AR 眼镜写代码的实际体验,有人分享了串流远程工作的方案。
- Bitter Lesson(https://www.cs.utexas.edu/~eunsol/courses/data/bitter_lesson.pdf):经典 AI 文章,对理解"计算通用方法胜过人类知识注入"有重要参考价值。
观点延伸
当天最值得咀嚼的判断,不是“强模型还需不需要 Harness”,而是:AI 编程的核心瓶颈,正在从“如何让模型写出来”转向“如何让系统能够拒绝不该留下的东西”。
1. Harness 不是越少越先进,而是要从“指挥模型”退回“约束系统”
群里有人认为 Astra、Fable 已经不需要 Spec,项目级 Harness 反而会污染上下文;另一边则指出,项目一旦进入多人协作或十万行规模,Spec 又会成为沟通基石。这两者并不矛盾:强模型可以减少过程提示,却不能消除系统事实。
真正应该被删掉的是“把每一步都教给模型”的静态脚本,而不是所有工程约束。模型可以自由决定实现路径,但接口契约、数据边界、不可违反的业务规则、验证命令和回滚方式,仍然应该被机器强制检查。好的 Harness 不负责告诉模型“下一行写什么”,只负责在模型越界时让结果无法合并。
因此,AGENTS.md 应该像宪法,短、稳定、人工维护;Spec 描述可验证的组件契约;ADR 只记录真正改变系统边界的决策。凡是不能转化为检查项、测试或运行时约束的长文档,很可能只是上下文噪声。
2. “oneshot”与持续交互的争论,本质是偏差是否会被反馈放大
群里对“尽量 oneshot,不对就重来”与“阶段性审查、逐步拐回”各有支持。工程上可以这样区分:一次性生成适合边界清楚、验证便宜、失败可丢弃的任务;持续迭代适合状态复杂、迁移成本高、必须保留既有行为的系统。但“让 AI 自己循环直到测试全过”并不等于可靠,因为测试只覆盖已知行为,无法自动证明设计没有悄悄漂移。
更现实的流水线应当把交互拆成几个有明确出口的阶段:先生成变更,再运行静态分析和测试,再检查差异规模、依赖边界与资源行为,最后才允许进入下一阶段。每个阶段都要能失败、重置,而不是把上一次错误输出继续喂给模型。这样做不是迷信人工 review,而是限制随机偏差的累积半径。
3. 输入法与 AI 编程其实在重复同一个教训
青简整句输入的准确率很高,但用户仍偏好 Rime 的字词输入,原因不是平均准确率,而是“我不知道它什么时候会错”。一旦错误需要持续检查,工具节省的输入时间就会被验证成本吃掉。AI 代码也是如此:生成速度不是生产力,能够以低成本确认“它没有偷偷改变别的东西”才是。
可继续实践的方向,是为 Agent 建立“信任预算”:每类任务先测量生成成功率、回归缺陷率、人工检查耗时和重做成本,再决定使用 oneshot、阶段审查还是完全人工实现。不要问“这个模型聪不聪明”,要问“在什么边界内,它的错误足够便宜”。