
外观
Emacs 社区日报 2026-09-12
自动整理自 Telegram 讨论组,每天更新。内容为 AI 摘要,仅作信息索引与回顾。
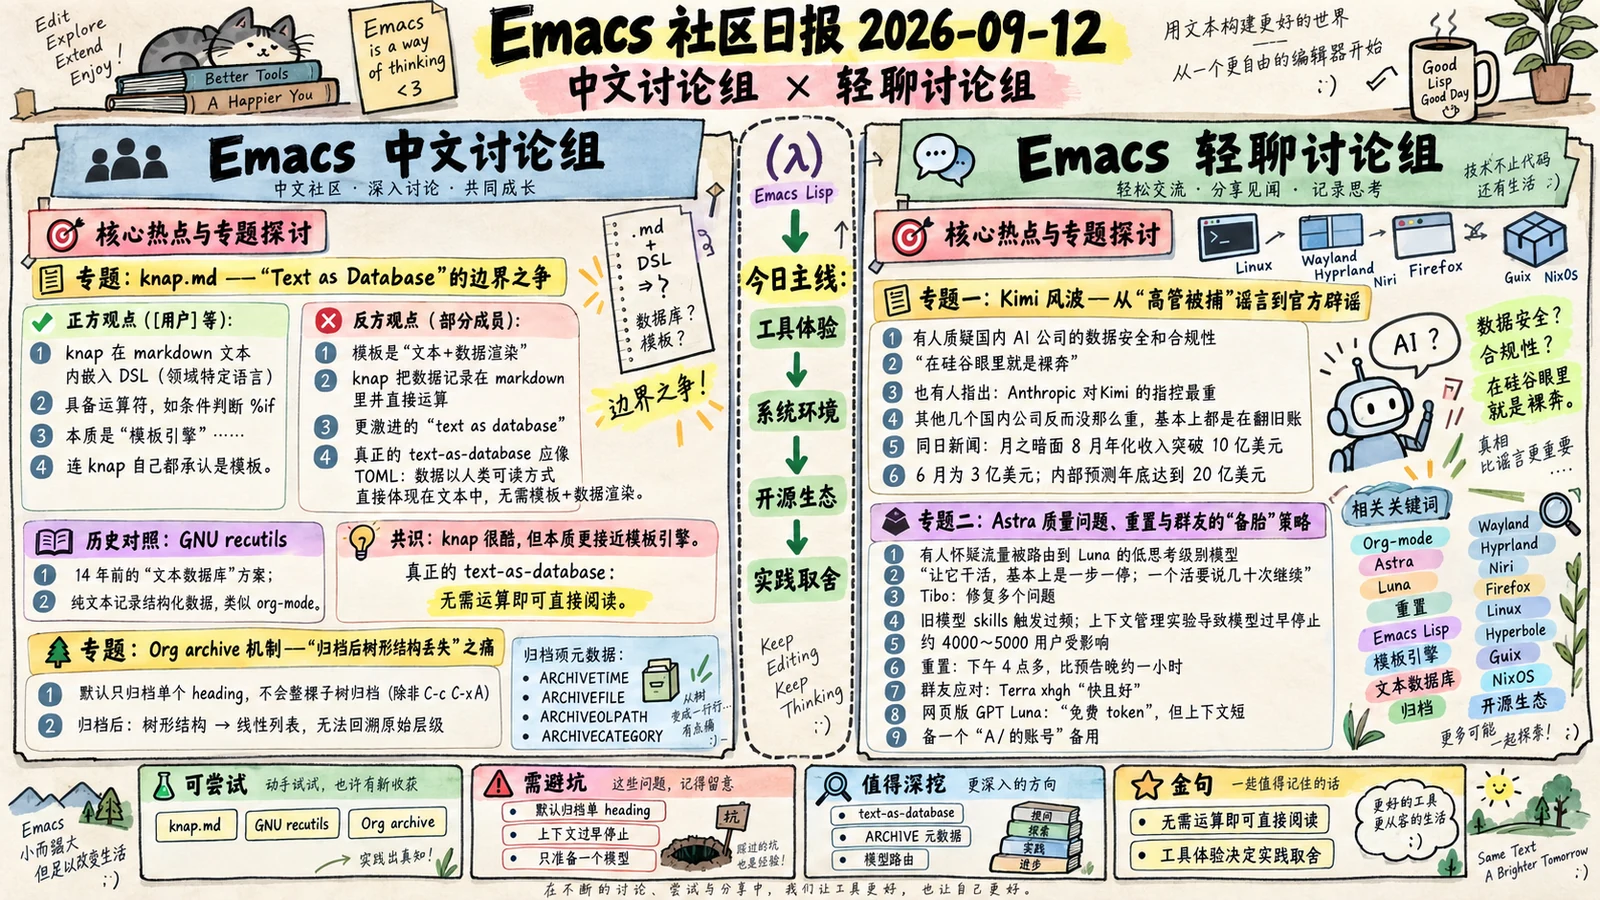
Emacs 中文讨论组
🎯 核心热点与专题探讨
专题:knap.md —— "Text as Database" 的边界之争
凌晨 Obsidian CEO Kapano(即 kapano 账号主人)发布了新语言 knap.md,宣称"把数据变成 markdown",群里围绕"这到底是模板还是数据库"展开了激烈辩论。
正方观点(@cubic_curve 等):
- knap 在 markdown 文本内嵌入了 DSL(领域特定语言),具备运算符(如条件判断
%if),这本质上是"模板引擎"——数据可运算,但结果最终要渲染成人类可读的 HTML 或 plain markdown。 - 连 knap 自己都承认是模板。
反方观点(部分成员):
- 模板是"文本+数据渲染",但 knap 把数据本身记录在 markdown 里并直接运算,是一种更激进的"text as database"尝试。
- 真正的"text as database"应该像 TOML 那样,数据以人类可读的方式直接体现在文本中,不需要通过模板+数据渲染才能得到结果。
历史对照:群友翻出了 GNU recutils——一个 14 年前的"文本数据库"方案,用纯文本记录结构化数据(类似 org-mode 的表格),Emacs 内置 rec-mode,且不依赖 Emacs 的发行版打包。群友认为 knap 和 recutils 有相似之处,但 recutils 没有条件化记录,更"纯粹"。
共识:knap 是"很酷"的尝试,但其本质确实更接近模板引擎。真正的 text-as-database 应该无需运算即可直接阅读文本内容。
专题:Org archive 机制——"归档后树形结构丢失"之痛
群友吐槽 org agenda 的 archive 机制"很神秘":默认归档后,原本的树形结构会变成线性排列,导致事后追踪归档项来源困难。
具体痛点:
- 默认只归档单个 heading,不会整棵子树归档(除非用
C-c C-x A) - 归档后结构从树变成线性列表,无法回溯原始层级
- 虽然归档项会附上
ARCHIVE_TIME、ARCHIVE_FILE、ARCHIVE_OLPATH、ARCHIVE_CATEGORY、ARCHIVE_TODO等 metadata,但仍不够直观
现有解决方案讨论:
- 直接加
:ARCHIVE:tag:保留在原文件里,用 tag 标记归档状态,配合C-c C-<tab>循环展开/折叠,文件不会膨胀("我直接删的比 archive 的多") org-archive-location变量:可以指定FILENAME::HEADING,但只支持%s和datetree/两个特殊字符串,datetree/用处不大(因为本来就会附加ARCHIVE_TIME)- 群友提到"或者可以加一个方式,不显示有
:ARCHIVE:的 heading"
情绪:群体对 archive 机制"不够灵活"感到不满,但 :ARCHIVE: tag + 自定义显示过滤的思路被普遍认可。
专题:SSH 爆破危机——"有人用我的网名尝试登录我的 vps"
凌晨 owdo 发现 VPS 突然炸了,SSH 连不上,后来恢复。更吓人的是,日志显示有人用他的网名 0wd0 作为用户名尝试登录,尝试次数高达 27279 次,来源 IP 分布广泛(328 次来自 203.154.158.195,326 次来自 211.223.107.86,还有 300+ 其他 IP)。
群友反应:
nami.yti指出"公网端口有职业搞安全的一直不停扫描,一般不可能只针对一个 IP",SSH 协议出海是透明的,识别机制可能正在改进拦截机制的测试。- 群友建议配置
fail2ban防护。 owdo表示"感觉要调一下我的 ssh 配置了"。
洞察:这次爆破尝试是典型的"字典攻击"(用常见用户名+网名组合猜密码),说明公网 VPS 暴露 SSH 端口极其危险,必须做好防护(如 fail2ban、密钥认证而非密码认证、限制登录失败次数等)。
专题:Emacs China 官方群组之谜
有人问"这个群是 emacs-china.org 官方群组吗",群里立刻炸锅:
- "不是"、"互不隶属"、"甚至有人用我的网名想要登录我的 vps"
- 群友说"emacs-china 我感觉都不让注册了,我打死都注册不了"
- 另一位群友说"你需要的话,我可以邀请你"
- 群友认为官方群应该是 QQ 群(群主是子龙山人),并调侃"还有找到其他的群吗,冒充的能活跃正经聊 emacs 也行"
背景信息:群 logo 是从 Emacs China 复制过来的,但实际与官方互不隶属。群里有几位 Emacs China 管理员,但并非官方群组。
🔑 关键概念与技术解析
- knap.md:Obsidian CEO 发布的新语言,把数据变成 markdown,支持在文本内嵌入 DSL 进行运算(如条件判断
%if)。本质上是一种模板引擎。 - recutils:GNU 的文本数据库工具,用纯文本记录结构化数据,类似 org-mode 的表格,Emacs 内置
rec-mode。不依赖 Emacs 的发行版打包,维护者是忠实的 Emacs 用户。 - org-archive-location:Org-mode 变量,指定归档位置为
FILENAME::HEADING,支持%s和datetree/两个特殊字符串。 - comint:Emacs 内置的通用交互子进程模式(如
shell-mode、term-mode),用于处理缓冲区中的命令输出和错误跳转。 - fail2ban:入侵防护软件,通过监控日志并动态调整防火墙规则来阻断恶意 IP。
- ghostel:一个 Emacs 相关项目(推测为某种模式或插件),群友讨论其在报错跳转方面的实现。
- lem:Common Lisp 编辑器,群友提到"修好 Linux 下的 lem 的 sdl2 了",并发布了 PR(
lem-project/lem/pull/2296),他硬 require 的应该改为 weak deps 才对。
💎 碎片知识与金句拾遗
- "这不重新发明模板吗" → 对 knap.md 的尖锐评价。
- "text as database不应该拥有需要compute的东西才对,至少内容要以人类可读的方式直接体现在文本中" → 对文本数据库本质的洞察。
- "toml 只是一种数据记录的格式,但 knap 明显是将数据在 markdown 里记录,和运算" → 区分了数据记录格式与数据运算语言。
- "ssh协议出海是透明的了" → 指出 SSH 流量可以被检测,暗示 VPN/代理服务的脆弱性。
- "删的主要是 ai 写的 slop" → 吐槽 AI 生成内容质量低劣,需要大量清理。
- "这两天仔细看了一下ai给我写了什么字,真的是一坨啊" → 对 AI 辅助写作的生动吐槽。
- "你要org(anize)啊👊" → 双关:既指 Org-mode,也指"整理"(organize),劝群友整理归档策略。
- "感觉org agenda的archive机制很神秘" → 对 Org archive 机制的普遍困惑。
- "我直接删的比archive的多" → 部分用户选择直接删除而非归档,因为归档反而增加管理成本。
- "看了下这个从 14 年前最早的 commit 就是这样的了,维护者 Daiki Ueno 看来是个忠实的 emacs 用户,也是 rpms/emacs 的维护者" → 对 recutils 维护者背景的挖掘。
- "奇怪的logo"、"真好玩" → 对 knap.md 的简短评价。
- "太贴心了 😃" → 对某个贴心设计(可能是 knap 的某功能)的赞叹。
🛠️ 值得深入研究的点 (Follow-up)
- knap.md 与 recutils 的对比研究:这两者虽然都试图"把数据放进文本",但哲学不同。值得深入分析 knap 的 DSL 设计(如
%if运算符)如何影响其"模板 vs 数据库"的定位,以及它在实际使用中的适用场景。 - org-mode 的 archive 替代方案:群友提到"加
:ARCHIVE:tag + 自定义显示过滤"的思路,值得进一步研究如何配置一个"不丢失树形结构、不膨胀文件"的归档工作流。可参考org-archive-location的配置和org-mode的org-agenda过滤功能。 - SSH 爆破防护实践:27279 次爆破尝试的日志数据非常有价值,值得研究如何用 fail2ban、密钥认证、端口敲门等方式有效防护。群友提到的"识别机制改进测试"(SSH 流量透明化)也是一个值得关注的趋势。
- lem 项目的 SDL2 修复 PR:
lem-project/lem/pull/2296涉及 Linux 下 SDL2 的修复,对于 Common Lisp 编辑器生态的开发者有参考价值。群友指出"硬 require 应该改为 weak deps",这符合依赖管理的最佳实践。 - Emacs China 注册问题:群友反映"打死都注册不了",官方群与 QQ 群的关系也引发讨论。值得进一步研究 Emacs China 社区的开放性和管理机制。
观点延伸
当天最值得咀嚼的,不是 knap.md 究竟该归入“模板”还是“数据库”,而是它暴露了一个更根本的边界:文本系统到底优先服务于人类阅读,还是优先服务于机器计算。若文本必须经过条件判断、数据展开和预览渲染,才能显现真正内容,它就已经从“记录”滑向“程序”。这不是贬义,但意味着它应当接受模板语言的工程约束:语法稳定性、错误提示、依赖管理、可测试输出,以及数据与表现层的明确分离。反过来,recutils 或 TOML 的价值不在于功能少,而在于打开文件即可理解,工具消失后数据仍然成立。对个人知识系统而言,原始文本的可读性和可迁移性,通常比表达能力更稀缺。
Org archive 的争论其实是同一个问题在时间维度上的表现。归档不是简单地“把旧东西移走”,而是在改变知识的可见性、层级和未来检索成本。Org 提供 metadata,说明它知道来源;但“知道来源”不等于“保留结构”。如果用户需要依靠属性字段重新拼出原来的树,系统就把维护成本从写入阶段转移到了回顾阶段。ARCHIVE tag 的方案看似不够纯粹,却保留了原始拓扑,只把“是否参与日常视图”从“文件位置”中分离出来。这更接近一种可逆的知识管理:隐藏可以,删除可以晚一点,结构不要先丢。
这也解释了群里对 AI 生成 slop 的反感:问题不是 AI 能不能生成文本,而是生成物是否增加了后续判断、筛选和修订的负担。无论是知识条目、Org heading 还是代码补丁,真正的质量标准都应是“几个月后还能否快速确认它为什么存在、从哪里来、是否仍然有效”。可读文本、保留结构、明确依赖、可跳转错误,表面上属于不同话题,实际上都在降低系统的解释成本。
可继续研究/实践的方向:做一个小型 Org 归档实验,分别比较“移动到 archive 文件”“原地加 ARCHIVE tag”“整棵子树归档”三种方案,记录创建、检索、回溯和批量隐藏的操作成本;同时为 AI 生成内容增加来源、状态和人工确认属性。不要先追求最自动化的方案,先验证哪种结构能让未来的自己最少重新理解。
Emacs 轻聊讨论组
🎯 核心热点与专题探讨
专题一:Kimi 风波——从「高管被捕」谣言到官方辟谣
凌晨开始,群里流传一张截图,声称 Kimi 创始人杨植麟与 15 名核心高管被捕,并牵扯出某安全机构(群友称「a➗」)的调查报告,指控国内 AI 大模型公司「套壳」「把敏感信息传递给美方 Claude」等。部分群友表示报告「看着挺真的」,案例丰富;也有人冷静指出「这事儿全网只有上面一张截图」,呼吁观望。
上午 11:57,月之暗面 Kimi 官方微博发布声明,称网传信息「纯属虚构,属于恶意造谣」,已向公安机关报案。群友吐槽:「辟谣都不给看人家说了啥,你这辟的什么谣」。
群友观点摘要:
- 有人借此质疑国内 AI 公司的数据安全和合规性,认为「在硅谷眼里就是裸奔」。
- 也有人指出 Anthropic 对 Kimi 的指控最重,「其他几个国内公司反而没那么重,基本上都是在翻旧账」。
- 结合同日新闻:月之暗面 8 月年化收入突破 10 亿美元(6 月时为 3 亿美元),内部预测年底达到 20 亿美元,增长主要得益于 7 月发布的 Kimi K3 模型,成本远低于美国竞品。这一背景让谣言显得格外刺眼——一家高增长明星公司为何会被传「高管全被捕」?
专题二:Astra 质量问题、重置与群友的「备胎」策略
Tibo(Astra 作者)发帖宣布对近期质量问题进行修复,并计划在「当地时间午夜」(北京时间下午三点左右)重置额度。群内多位用户反馈 Astra 近期体验极差:
- 有用户怀疑自己的流量被路由到 Luna 的低思考级别模型:「让它干活,基本上是一步一停。一个活要跟它说几十次继续」。
- Tibo 承认修复了多个问题:旧模型 skills 触发过频、上下文管理实验导致模型过早停止(约 4000~5000 用户受影响)、移除配置不当的 engines。
- 重置实际发生在下午 4 点多,比预告晚了约一小时,群友调侃「说是下午三点左右」。
群友应对策略:
- 有人改用 Terra xhgh:「没啥毛病,快且好」「至少能连续干活,我用的 terra max」。
- 有人白嫖网页版 GPT Luna:「一分钱不用出」「终于让我用到免费 token 了」,但上下文短、插件体验差。
- 也有人建议备一个「A/ 的账号」备用,「现在轮到他们那边负载不那么高了」,付款方式为「找卡商代充」。
专题三:国内 AI 编程工具吐槽——「AI slop」还是真香?
围绕 ZCode(智谱 AI 的编程 Agent)展开激烈吐槽:
- 「这种软件比 IDE 还重,打开啥都不干就 1.5g 没了」。
- 「更恶心的是完全不做 Linux 支持的」。
- 有人表示「如果不是为了 token,我下都不想下」,甚至想「逆向个接口」,拿 GLM 自家的 agent 去逆向自家接口。
- 有群友为 ZCode 辩护:「我感觉其实 zcode 做的也还算可以的了」,但随即有人对比 Devin 的 desktop:「真的是一坨狗屎」。
- 核心批评概括为:「都是 AI slop,除了能跑起来以外其他一概不管」「当然每个 AI slop 背后都是 human slop」。
🔑 关键概念与技术解析
Hysteria2 vs anytls(代理协议选型):群友分享自建代理经验时提到,Hysteria2 基于 UDP,但「大部分运营商限速甚至直接掐断」UDP;建议改用 anytls(一种基于 TLS 的代理协议)。有群友反馈自己的运营商 UDP「跑几秒就掐」,解决方式是「五秒重新建立一次连接」来维持体验。
WARP 出口路由策略:个人代理项目中,将 AI 流量单独路由到 Cloudflare WARP 出口,避免与廉价 VPS 机房 IP 混在一起。Claude/Anthropic 流量则再接一个固定 SOCKS5。作者明确「不保证账号安全」,这种不忽悠的态度获得群友好评。
AI slop:指那些「能跑起来但质量堪忧」的 AI 生成物/产品。群友用来概括当前大量 AI 编程工具的通病——功能堆砌但工程化粗糙,背后是「human slop」(人的敷衍)。
Harness(AI Agent 的执行框架):讨论 Astra 问题时提到「这 harness 好坏也看不出来」,指 Agent 的执行编排层(工具调用、步骤规划),属于决定 Agent 行为质量的关键组件。
💎 碎片知识与金句拾遗
- 字体安利:群友分享了 https://luowei.atelier-anchor.com/「这个字体很酷」。
- 金句:「穷玩车,富玩表,顶富 Astra 说你好」——调侃 Astra 的尊贵地位。
- 「有时候,认识字是一种罪过」——看到某条让人不适的新闻后的感叹。
- AI 吞并数学的讨论:「需求明确,系统封闭,公域知识,都刻在 llm 参数骨子里了」;「这是数学的最好时代,至于数学家,谁关心呢」;「中世纪一千多年都没有灭掉数学,不慌」。
- Anthropic 监控系统新闻引发讨论:「会走向终结者线还是黑客帝国线」,群友答「黑客帝国线」。
- 设计技巧:有群友分享「把 # 符号当成子项目的标识,然后在 fetch 和 push 的时候自动过一遍 filter」——Git 分支/项目的轻量级管理思路。
- 生活经验:「我发现一般笔记本店的清理都做得不错,别自己整了,直接送店里」——针对小风扇积灰问题。
- GPT 版本迭代:「gpt 6 出来以后 5.6 也不耐用了」——模型迭代速度之快。
- OpenAI 收购 Git AI 项目:「符合 openai 的目标,或需要人才就能收购」「一年前发起的项目,一看 star 2.6k」——讨论 OpenAI 通过收购快速补足代码能力。
🛠️ 值得深入研究的点 (Follow-up)
personal-edge-proxy(自建 AI 代理路由): https://github.com/yding-git/personal-edge-proxy —— 将 Hysteria2 主入口 + WARP 分流 AI 流量 + 固定 SOCKS5 兜底的整套路由思路。群友实测「1核1G 小鸡就能跑」,适合有自建代理需求的开发者。作者不吹「一定不封号」的诚实态度也值得借鉴。
anytls 代理协议:当 Hysteria2 的 UDP 被运营商掐断时的替代方案,值得关注其与传统 Trojan/VMess 的兼容性与性能差异。
Astra 重置后的质量验证:Tibo 声称修复了 skills 触发、上下文管理实验、engines 配置等问题,并已完成额度重置。群友可以实测对比重置前后的 Agent 连续工作能力,尤其是「是否还会一步一停」。
Terra xhgh:群友推荐的高质量编程模型,称「快且好」「能连续干活」。作为 Astra/Claude 之外的备胎方案,值得进一步评估其在复杂重构任务中的表现。
ZCode 逆向思路:有群友提到想「逆向个接口」拿 GLM 自家 agent 去逆向自家接口,虽然更多是吐槽,但这类客户端接口逆向的技术路径(抓包、协议分析、token 复用)值得技术人关注。
观点延伸
当天最值得咀嚼的,不是某个模型“聪不聪明”,而是 AI 服务的可靠性正在从模型能力问题,变成系统工程问题。
1. Agent 的连续工作能力,本身就是核心指标
Astra 用户描述的“一步一停”,表面上像模型降智,实际可能来自 skills 触发、上下文管理、模型路由、engines 配置等多个环节。Tibo 的说明也印证了这一点:模型即使能力足够,只要编排层过度打断、过早总结,或者把请求送进质量不稳定的后端,最终体验就会像一个需要不断催促的实习生。
这说明评估 Agent 不能只看单轮回答、榜单分数或一次性代码片段,而要测“任务闭环”:它能否连续调用工具、保留目标、检查结果、处理失败,并在十几步之后仍不偏离。工程上可以把它拆成几个可观测指标:平均连续步骤数、无效停顿率、工具调用成功率、返工次数、最终测试通过率。所谓 harness 的好坏,必须通过这类轨迹数据验证,不能靠宣传或体感争论。
2. “备胎策略”不是消费习惯,而是架构判断
群友从 Astra 切换 Terra,或使用网页端服务,并不是简单追逐哪个模型更强,而是在承认:任何单一 AI 供应商都可能出现限额、路由异常、上下文缩短、插件失效或服务延迟。把工作流绑定在一个入口上,就等于把个人生产力交给对方的内部实验和运营节奏。
因此,个人 AI 工具链应当具备最小的故障转移能力:任务状态放在本地可读的项目文件或日志中,而不是只存在聊天窗口;模型调用入口尽量可替换;复杂任务要能从中断点继续;关键操作必须由测试、版本控制和人工检查兜底。这样切换模型不是“重新解释一遍需求”,而只是更换执行器。
3. AI slop 的根因是缺少验收闭环
“能跑起来”并不等于产品成立。ZCode 被批评占用大量资源、缺少 Linux 支持、强迫用户留在封闭客户端,真正暴露的是工具团队把上线当作终点,而不是把可验证的使用闭环当作产品的一部分。AI 产品尤其容易如此:生成能力制造了功能幻觉,但性能、可移植性、可恢复性和调试能力没有同步建设。
可继续研究或实践的方向是:为同一个真实重构任务建立一套跨模型 Agent 基准,记录从需求澄清到测试通过的完整轨迹,并比较不同 harness、模型路由和上下文策略对最终交付质量的影响。届时,“快且好”或“低思考但省 token”才会从口碑,变成可复核的工程结论。