
外观
Emacs 社区日报 2026-09-08
自动整理自 Telegram 讨论组,每天更新。内容为 AI 摘要,仅作信息索引与回顾。
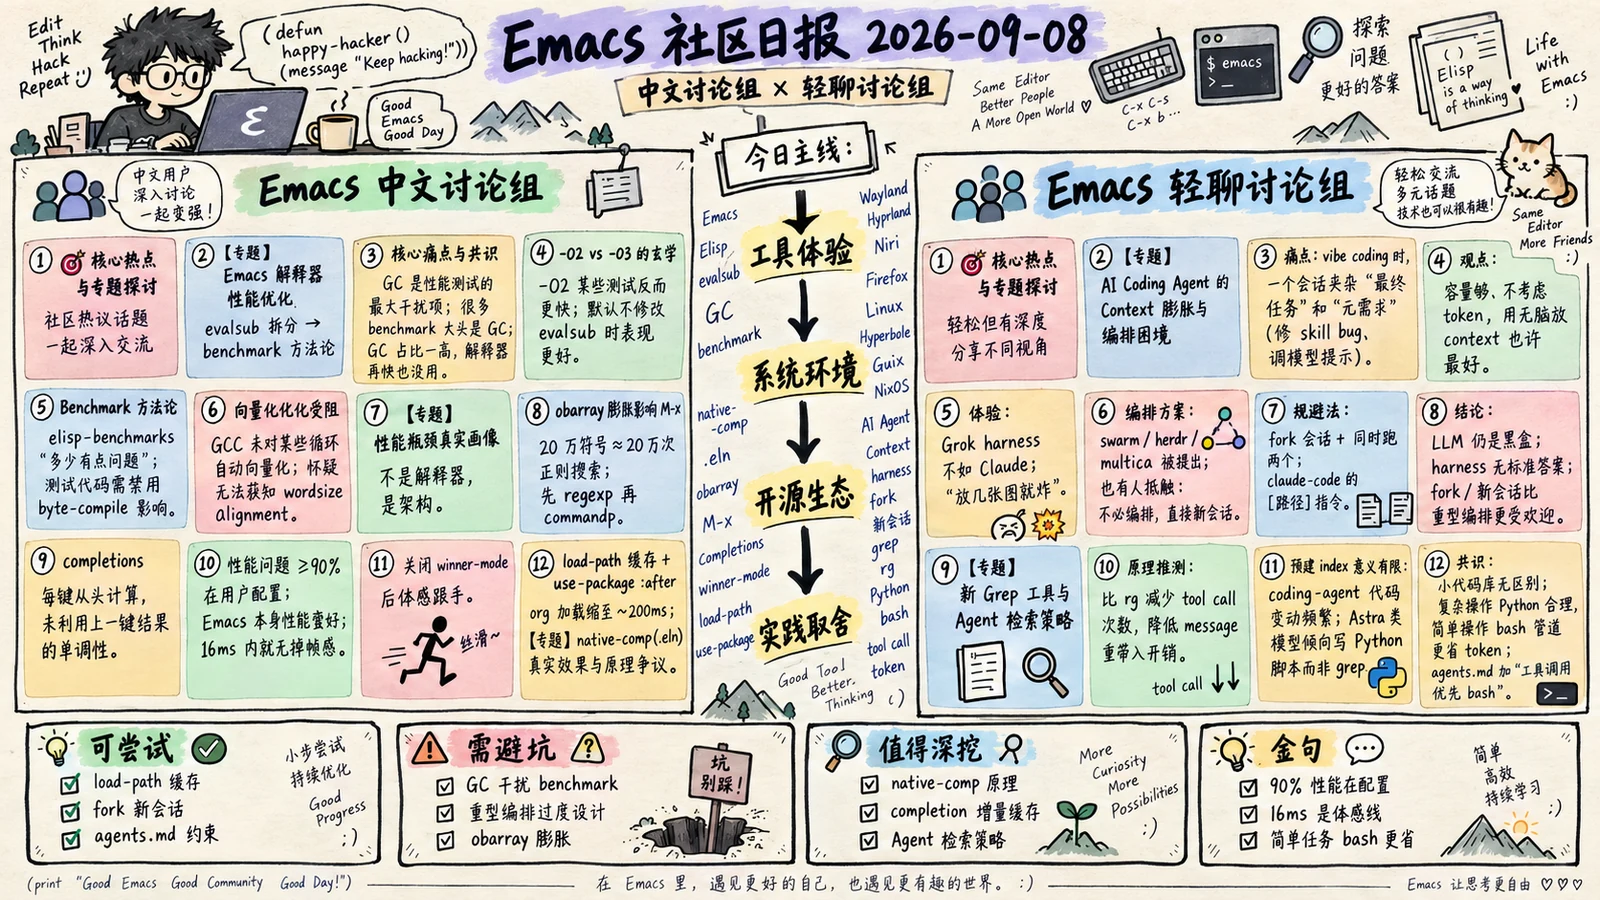
Emacs 中文讨论组
🎯 核心热点与专题探讨
【专题】Emacs 解释器性能优化:从 eval_sub 拆分到 benchmark 方法论
群友 eXkeql 对 Emacs 解释器核心路径 eval_sub 进行了函数拆分优化(commit 0076b8df578),在纯解释模式的素数求和测试中观察到约 5% 的纯解释性能提升,objdump 确认减少了大量 push 指令。但在 elisp-benchmarks(Andrea Corallo 编写,native-comp 作者)上效果仅约 1%,且存在噪声。
核心痛点与共识:
- GC 是性能测试的最大干扰项。 多位群友反复强调:很多 benchmark 的大头是 GC,解释器跑再快也没用。GC 占比一高,解释器优化几乎不可见。素数测试因为"简单对象多、直接返回更快"所以能体现差异,真实场景未必。
-O2vs-O3的玄学: 奇怪地,-O2在某些测试中反而比-O3更快,且默认不修改eval_sub时表现更好。可能与 cache prefetcher 行为有关。- Benchmark 方法论问题: 群友认为
elisp-benchmarks本身"多少有点问题",测试代码需要禁用byte-compile才能测纯解释性能,一轮跑 15 分钟。elb-scroll、inclist、inclist-type-hints三个测试需要剔除。 - 向量化优化受阻: 另一群友发现 GCC 未对解释器中某些循环做自动向量化,怀疑是编译器无法获知
word_size的 alignment 信息。确认word_size是编译期常量后,问题仍未解决,怀疑是 GCC 的问题,建议等 GCC 17(当前最新稳定版为 16.2.1,所谓 "gcc17" 实为 master)。有人建议尝试用 LLVM 编译 Emacs 对比。
【专题】Emacs 性能瓶颈的真实画像:不是解释器,是架构
群友 κόσμος 用 15 秒 native 样本做了 profile,给出了极具价值的结论:
redisplay 调用树占 34.8%,但其中 mode-line 路径占 20.2 个百分点;IGC trace/fix 占 39.8%,并与 redisplay 重叠 16.3 个百分点。当前最有希望的共同来源不是"画字太慢",而是 redisplay 在重算 mode-line、分配 Lisp 对象,进而触发 IGC 扫描。
进一步发现:
obarray膨胀影响M-x速度: 20 万个符号意味着 20 万次正则搜索。当前实现先跑正则匹配再跑commandp,但先跑commandp就能大幅缩减候选集。代码位置在read-extended-command-1(simple.el)。completions每键从头计算, 未利用上一键结果的单调性。- 性能问题 ≥90% 出在用户配置上, Emacs 本身性能蛮好。延迟降到 16ms 以内就不会有掉帧感。
- 关闭
winner-mode后体感跟手。 load-path缓存 +use-package的:after/idle-load 策略 可将 org 加载缩至 ~200ms,magit/org 秒开。
【专题】native-comp(.eln)的真实效果与原理争议
群内对 native-comp 的效果存在显著分歧:
- 体感层面: 多数人在日常使用中"完全感觉不出 eln 和 elc 的区别"。Linux 上 Emacs 本身就很快,不需要 native-comp。Windows 上开启后能减缓函数调用时的小卡顿。magit 在函数密集调用(如子模块展开)时体感明显。
- 原理澄清:
κόσμος明确指出 native-comp 是 AOT 不是 JIT——"单纯编译而已,哪来的优化"。它用 gccjit 把 elisp 编译成机器码,没有运行时 trace 收集、没有 PGO。有人追问"gccjit 支持 trace 吗?难道是 PGO 思路?"——答案是否定的。 - 加载开销: 启用 native-comp 后,加载时需重算哈希判断 eln 是否过时,增加启动时间。
- 社区现状: Andrea Corallo 基本是 native-comp 的唯一维护者。
【专题】Elisp 多线程化:一个被充分辩论的提案
群友提出:将 elisp 代码标记为 safe/unsafe,safe 代码可多线程并行,unsafe 加全局锁,逐步迁移。
反对意见(主要来自 κόσμος):
- 全局锁保护的不是线程而是数据,仍需先把 GIL 拆成细粒度锁。
- Elisp 大量全局变量、函数行为不靠参数控制,"safe 不了"。
- 锁的需求会向调用者传播(类比 JS 的
async污染),最终结果全是锁。 - Elisp 的同步等待补全机制(如 Eglot)是社区共识优点,异步 API 会破坏"在任何地方改任何地方的任何逻辑"的灵活性。
- 更务实的路径:把图形渲染单独拎出一个线程,或改进解释器/GC,而非全面多线程。
【专题】Windows 上编译 telega.el:ucrt vs msys2 的噩梦
群友 zdn_y 完整记录了 Windows 下编译 telega.el 的踩坑过程:
- 根因:
tdlib需要 ucrt 环境编译,telega-server使用 POSIX API 需要 msys2 环境,两者头文件冲突。 - 解决方案: 用 ucrt 编译 tdlib 后,不安装到 ucrt 目录,而是安装到独立路径(如
AppData/Roaming/.emacs.d.cache/tdlib),编译 telega-server 时通过LIBS_PREFIX指向该路径。 - 更简方案: 将 Makefile 中
CFLAGS的-I改为-idirafter,让pthread.h/signal.h/sys/wait.h优先走 msys,tdlib 头文件走 ucrt。 - 已知可用版本: tdlib
022d602,telega.el79c1735。 - 建议贡献上游改 Makefile,但作者最近在忙车库。
【专题】Windows TSF 输入法支持
Windows 11 已默认切换到 TSF(Text Services Framework),但 Emacs 仍使用老旧的 IME 接口。群友计划为 Emacs 实现 TSF 支持,但面临巨大工程量:微软最简 TSF 示例项目就要 6000 行 C++,用 C 写要 ×2。 动态模块接口层支持 C 和 Rust,但 TSF 本身是 COM 接口,可能必须用 C++。elisp-benchmark 作者 eli 对是否引入 C++ 持保留态度。
【专题】Emacs 显示引擎与渲染
- lucid 比 pgtk 快很多, 但 lucid 当前是坏的(redisplay 不更新),已存在快半年没人修。
- 有人在 emacs-devel 上讨论 SDL terminal type 的实现。
- 计算与绘制不分离 是 Emacs 架构层面的根本问题,导致 GC 触发时界面重绘卡顿。
- IGC(Ink GC)可改善尾延迟约 4 成,但整体吞吐和延迟会变差。
org-agenda因纯文本文件扫描("file as database")而极慢。
🔑 关键概念与技术解析
elisp-benchmarks: Andrea Corallo(native-comp 作者)编写的 Emacs Lisp 性能基准测试包,发布在 ELPA。原本为测试 native-comp 效率设计,不适合纯解释器测试(默认会做 byte-compile)。eval_sub/eval_sub_1: Emacs 解释器中eval的核心实现函数。拆分eval_sub可减少函数调用开销和寄存器压力。- IGC (Ink GC): Emacs 的实验性垃圾回收器,支持用户中断(可中断 GC),目标是降低尾延迟,但整体性能会变差。
obarray: Emacs 内部存放所有 symbol 的哈希表。运行时间越长、加载的包越多,obarray 越大,影响M-x、mapatoms等全局符号遍历操作的性能。- TSF (Text Services Framework): 微软的新一代输入法框架,Windows 11 默认使用。相比旧 IME 支持更复杂的输入场景,但 API 极其复杂(COM 接口,最简示例 6000 行 C++)。
package-quickstart: Emacs 内置功能,可将所有包的 autoload 合并到一个文件中减少启动时的文件搜索。仅对package.el有效。borg: 一种 Emacs 包管理方式,将每个包作为 git submodule 管理,支持生成聚合 autoload 缓存。- neoemacs (
sincebyte/neo-emacs): Emacs 的一个硬分叉项目,群友称"还需要一个半月就差不多了"。 debuff/LocalAudioSTT: 群友sincebyte开发的 Emacs 语音输入工具链,演示了"边说边粘,光标处文字自己长出来"的效果。word_size向量化问题: Emacs 解释器 C 代码中的编译期常量,GCC 未能据此做自动向量化,怀疑与 alignment 信息传递有关。
💎 碎片知识与金句拾遗
- "回一封邮件我花了1个小时左右"——Emacs 用户的日常(或不是)。
- "感觉真要抠细节优化的话点还挺多的,解释器、GC、JIT……qs,没有很多人关注这些。"
- "就当AI大人带我学习工业解释器的妙妙优化了。"
- "解释性能真是弱鸡啊 elisp。"(禁用 byte-compile 后一轮 benchmark 跑 15 分钟)
- "7640HS 太弱了。"
- "感觉 elisp 还是太难搞了。" / "jit太难做了,elisp太动态了,很难优化。"
- "elisp 太动态了……毕竟允许 hack 函数。"
- "DCE(死代码消除)之类的不太好做。"
- native-comp 原理讨论中:"实际上就是单纯的编译而已……哪来的优化。" / "那也太抽象了吧。不如优化 elisp interpreter。"
- "gccjit 支持做 trace 嘛(" / "难道是 PGO 的思路" / "jit的优势就是在pgo" / "说实话"
- "单纯优化 elisp 的解释器是不是带来不了质的提升?" / "肯定要专门做啊。"
- "你们能理解这种绝望吗"(TSF 最简示例 6000 行 C++)
- "别执着,该找工作了。" / "确实。"
- "我属于那种去人力市场一定会被刷的那种。" / "我之前不是写代码的,只是最近几年慢慢接触会了那么一点。"
- "我觉得是对草台班子的感悟还不够深。"
- "什么时候赚够了能靠被动收入活了就可以做点更有意义的事去。" / "我决定压缩自己的欲望,换取早日退休。"
- "还好我没有工作,可以专心搞 lem。"
- "求求大家学一点计算机科学吧。"(关于编译器向量化讨论)
- "rust 的 +nightly 还是太超前了。"
- "你们 C 语言的特性太少了,没办法方便表达编译期求值。"
- "感觉没有 jit 的话和 lua 比简直路边一条啊。"
- "file as database 😈"(评价 org-agenda 用纯文本文件做查询)
- "org 就不要想这个了,org 尽可能在闲时直接增量加载进来。"
- "magit 这类都是同样的策略,放入一个队列,都 require 完了,到你打开的时候实际上都载入完了就快了。"
- "感觉最慢的是 agenda,简直神人,不用 sql 用纯文本文件。"
- "一直用等宽字体解决的,Noto Sans Mono CJK SC。"(关于 Markdown 表格渲染)
- "org-mode 的 table 也可以很好地显示了……光标经过则显示为原表格,完全不影响正常 table 的编辑。"
- "把 winner-mode 关掉后感觉跟手了一点。"
- "emacs 好多设计感觉都很不 scalable。" / "什么时候改掉这种工作模式就好了,计算和绘制分离。"
- "codex-ide 的问题,用了过时的 json 函数。"
- "感觉 elisp 还是太难搞了。"
- "Linux 上面 Emacs 感觉就没有性能问题。"(然后被 spam 了)
- "群友太有钱了,能直接烧 API。"
- "感觉 codex-ide 是不是多少有点 vibe 产物。"
- "我之前部署 qwen 大模型,用社区 llama 加速版本在 Windows 上 cmake 构建,报了上万行错误,凭感觉加了个 NOMINMAX 宏给编译过去了。"
- "不会看构建日志就很简单,不会就很难。"(关于 telega 编译)
- "tdlib 是 ucrt 类的,telega-server 是 msys 类的……解决办法是用 ucrt 编译好 tdlib 以后,把 tdlib 单独安装到其它地方。"
- "CFLAGS 的
-I改成-idirafter就好了。"(解决头文件搜索顺序冲突) - "微软最简单的示例项目实现 TSF 要 6000 行,用 C 语言得 ×2。"
- "DirectWrite 实现彩色 Emoji 就是这么做的(手搓 COM)。"
- "emacs 只需要单线程足够快就可以了。"
- "我觉得要把 elisp 提升到 c/cxx 的 1/3-1/2。"
- "之前社区说得很对,elisp 本身太慢了。"
- "一直不觉得 magit 慢,除非在 windows 上。" / "我在 m 系列芯片上仍然觉得慢(子模块多的时候)。"
- "borg 用户应该是明显的(magit 子模块展开慢)。"
- "straight 必须另生成一份 build,都是有代价的。"
- "我觉得有些特别的场景,在 nix 下很麻烦。"
- "做了 load path 缓存和 once,magit 和 org 都是秒开。" / "不过 once 体验不是很好啊,难道是我 delay 设置太小了。"
- "obarray 里有 20 万个符号就会运行 20 万次正则搜索。"
- "现在的 completions 每键都从头计算,没有运用上一键的结果。如果利用单调性,也可以加速很多。"
- "补全如果能在后台计算就好了,先把 UI 绘制出来,然后填充候选项。"
- "emacs 没有 regexp compile,这似乎也是一个可以改进的点,考虑到正则的用量极大。"
- "同步等待的补全机制社区都认为很好,大家都统一了。如果你这个方案社区能认可,懒猫的 acm 就不至于被排斥了。"
- "只有 emacs 这样你才可以在任何地方改任何地方的任何逻辑,如果是异步 api,就不好用了。"
- "实在慢的地方你用动态模块外接加速一下算了,比如计算密集型的。"
- "动态模块解决不了问题,buffer 是有锁的。buffer 如果是异步的,你就不能在 buffer 渲染以外的位置实时修改 buffer。"
- "emacs 插件生态的活跃程度本来就一般般啊。"
- "neo 硬分叉了。"
- "我感觉 modeline 最慢的是 breadcrumb。我自己给所有组件做了异步缓存,modeline 只需要渲染字符串。"
- "或许 modeline 改成异步渲染的就能解决一大问题。"
- "延迟降低到 16ms 以内就不会有掉帧的感觉。"
- "性能问题 ≥90% 出在用户配置上。我测的结果是 Emacs 本身性能蛮好的,但是开了很多东西之后就慢了。"
- "感觉讨论这些事情太麻烦,等我退休再考虑优化 emacs 吧
观点延伸
这两天最值得留下的判断是:Emacs 优化首先要减少用户等待路径上的工作,其次才是把剩下的工作算快。解释器微优化与多线程提案看似相距很远,实际上都绕不开同一个问题:你究竟准备消除哪一次等待,又愿意为此改变哪些行为?
1. 指令少了,不等于用户少等了
eval_sub 拆分在素数测试里出现收益,换到其他基准却接近噪声,甚至出现退化。这不是微优化没价值,而是它的收益边界尚未确定。GC 对解释器实验可能是干扰项,对真实使用却是必须计入的成本。
同样,那份 mode-line 与 IGC 的采样提供了排查线索,却还不能证明因果,更不能外推到所有配置。下一步应当是移除或缓存可疑组件,观察分配量与交互延迟是否一起下降,而不是看到调用树重叠就宣布找到根因。
群里已经有人让 Agent 跑实验、读编译器源码。这里更值得自动化的不是“寻找更多补丁”,而是固定编译选项、交替运行基线与改动、保留失败结果。否则,产出补丁越快,挑中偶然好成绩的机会也越多。
2. 并发不是贴标签,缓存也不是免费午餐
safe/unsafe 提案真正困难的地方,不是名称,而是共享状态的所有权:后台计算期间,buffer 被修改、函数被重定义,结果还算不算有效?不给这些问题明确答案,“不卡界面”就可能变成“界面流畅地显示错误结果”。
群里“mode-line 只渲染缓存字符串”的实践提示了一条更小的切口:先把计算移出重绘路径,再讨论是否需要线程。但定时执行不等于并行,缓存也必须约定失效条件、允许陈旧多久,以及旧任务能否覆盖新结果。
补全讨论恰好给出了反例:沿用上一键候选,只有在匹配规则和候选来源满足相应条件时才安全;群友已经指出存在不单调的情况。优化不能靠默认所有插件都守着一个未声明的约定。
可继续研究/实践:先做一个能否定自己的实验
选一个慢 mode-line 组件,对比实时计算、事件驱动缓存、关闭组件三种状态。在同一配置下重复编辑与窗口切换,分别记录命令执行和后续显示耗时、尾延迟、分配量,并测试快速切换 buffer 后是否显示过期内容。
验收不是“截图看起来更快”,而是等待稳定减少、内容仍然正确。如果缓存无效,就撤回假设,继续排查。能让错误思路尽早出局的实验,比“把整个 Emacs 改成多线程”的愿景更接近工程进展。
Emacs 轻聊讨论组
🎯 核心热点与专题探讨
【专题】AI Coding Agent 的 Context 膨胀与编排困境
这是当日讨论密度最高、观点碰撞最激烈的话题。
痛点: 群友普遍反映在 vibe coding 时,一个会话里同时夹杂"最终任务"和"元需求"(修 skill bug、调 mermaid 格式、转 SVG 等),严重污染 context。Grok 尤为严重——代码直接全量塞 context 而非像 Claude 那样摘取,图片 base64 也直接进 context,导致三四轮对话就触发压缩(阈值 850K)。
各方观点:
- 有人认为"容量够、不考虑 token 用量的话,无脑放 context 就是最好的";
- 但实际体验是 Grok 的 harness 远不如 Claude,"放几张图就炸";
- 编排方案(swarm、herdr、multica)被提出但遭到抵触:"完全用不着编排,直接新开一个会话就好了";
- 有人用
fork会话 + 同时跑两个的方式规避,也有人提到 claude-code 的/btw指令。
结论倾向: 当前 LLM 仍是黑盒,harness 设计没有标准答案;轻量方案(fork / 新会话)比重型编排更受 Emacs 系开发者青睐。
【专题】新 Grep 工具与 Agent 检索策略
阿里和微软(将用于 CodePilot)分别推出新 grep 工具,微软声称代码检索 token 消耗最高减少 80%。
争议点:
- 原理推测:比
rg减少 tool call 次数,从而减少每次调用时 message 重带入的开销; - 但 coding-agent 代码变动频繁,需要预建 index 的工具"意义不大";
- Astra 类模型现在倾向直接写 Python 脚本而非调 grep,绕过了检索问题;
- 群友共识:小代码库无区别;复杂操作用 Python 合理(bash 字符串处理太繁琐),但简单操作 bash 管道组合更省 token。
实操建议: 在 agents.md 里加一条"工具调用优先使用 bash"约束,可能改变模型行为。
【专题】Emacs 视频播放器打磨
围绕一个 Emacs 内嵌视频播放器的使用体验持续迭代:
F键默认只弹一小块,需再按H/W全屏;建议初始状态自动 fit(涉及video-display-buffer-function);- 中键/滚轮拖动(轨迹球支持左右滚轮),Shift+滚轮水平滚动;
- 快捷键:上下=音量,左右=±5s,Shift+左右=±30s;
- 在线视频:
bili.el+chirp项目支持 B 站; - 已知 bug:buffering(黑屏转圈)时退出会卡一下。
🔑 关键概念与技术解析
| 概念 | 解释 |
|---|---|
video-display-buffer-function | Emacs 视频显示时决定 buffer 布局的函数,控制初始窗口尺寸 |
codex-chatgpt-web | 将 ChatGPT 网页版嵌入 Codex CLI 的开源项目(github.com/miuuyy/codex-chatgpt-web),可让 Codex 调用网页端 Pro 模型 |
astra | 一类 coding agent 模型,倾向生成 Python 脚本而非调用 bash tool 来完成任务 |
herdr | Agent 编排工具,可从 leader agent 派生 worker agent 处理杂活,避免污染主 context |
swarm | 开源 agent 编排项目(github.com/SaarthurR/swarm),类似闭源 slate 的 worker 派发模式 |
md-mode 的 C-c C-v | 进入渲染模式使 Markdown 表格对齐;不进入则保留原始 ` |
cursor-type | Emacs 变量,控制光标形状;某些插件会覆盖它导致光标闪烁异常 |
chezmoi → Home-manager | dotfile 管理工具迁移方向;Home-manager 6 月曾有一个已知坑 |
pi / omp | 当前群内主流 coding agent 工具(omp 会生成 JS 脚本) |
💎 碎片知识与金句拾遗
- DHH 发推(2096695103104393606),群友转发围观,未展开。
- Deltalake/DeltaDB 送 $100 额度,"这几天刷推都没看到人分享"——白嫖信息差。
- jj (Jujutsu VCS) 支持疑似做了但有 bug,"没绷住"。
- Rime 输入法:给 Emacs 打小优化后"经常炸","看起来还是不太靠谱"。
- GPT 把硬盘设成只读,而
.bashrc里有自动写入的启动命令 → 直接卡死进不去 shell。经典翻车。 - Passkey + Linux + YubiKey:macOS 原生支持 passkey,Linux 不行;有人打 patch 让 codex-chatgpt-web 的内置浏览器能识别 YubiKey 完成登录。
- base64 编码体积:原始文件的 ~1.3 倍(有人坚称 3 倍,实际取决于实现);Unicode 转义约 4 倍。但"放到上下文里编成 base64 不代表 AI 用 base64 理解,直接看 token 消耗对不上"。
- Grok-build 开源了,但"那一百万行 Rust 感觉纯 AI 写的"。
- aider 已经很久没人提了,"都去用 codex / claude code / pi 了"。
- Servo 对比:"这个(某项目)居然这么成熟?隔壁 Servo 都不知道还在哪里。"
- Linux 视频剪辑:达芬奇还没用过,kdenlive "是真的简洁好用"。
- diffusionstudio/editor:代码驱动的编辑器思路,群友评价"思路挺好"。
- Emacs/Lisp 被污名化的感慨:"操作系统不是 Lisp Machine 不够正统 🌚"。
- AI 的审美:"AI 的审美还是在线的"(评价某个播放器 UI)。
- 在 Emacs 里做视频剪辑 IDE 的许愿帖,回应:"写剪视频的程序倒是可以,自定义快捷键算不算优势 hhh"。
- md-mode 接受纯 AI PR,作者 yibie 的仓库里出现 "LuciusChen" 署名(因为之前让 GPT 学习过 luciuschen 的 Emacs 配置),"lucius 宇宙 😂 只 tm 学习了一次……"。
- 2019 年已经过去 7 年了(群友突然感慨时间)。
- uv 背后团队被招安,"总得搞点东东吧 😂"。
- 面试趋势:"AI 八股文"——有人担心面试开始问 agent 编排,回应:"等你想招某人,你也会问八股的"。
🛠️ 值得深入研究的点 (Follow-up)
| 项目/方向 | 关注理由 |
|---|---|
| miuuyy/codex-chatgpt-web 及 0WD0 的 fork | 将 ChatGPT Pro 网页端接入 Codex CLI;Linux + YubiKey passkey 的 patch 值得看 |
| emacs-im/bili.el + emacs-im/chirp | Emacs 内播放 B 站在线视频,生态早期 |
| zHaOdANiuu/material-icons.el | MELPA 可装,Emacs UI 图标方案 |
| diffusionstudio/editor | 代码驱动编辑器思路,与 Emacs 哲学有交集 |
| SaarthurR/swarm | 开源 agent 编排,对比 herdr / multica 的 worker 派发模式 |
| 微软/阿里新 grep 工具 | 声称 token 消耗降 80%;关注是否集成进 CodePilot 默认工具链,以及能否在 pi/codex 等第三方 agent 中复用 |
| Codex 系统提示词长度对比 | 群友反馈"有点太长"但"不够 Claude 的长",值得对比两家 system prompt 对 agent 行为的影响 |
agents.md 约束偏好 | 用一行自然语言约束 agent 的工具选择偏好(如"优先 bash"),低成本实验 |
| Home-manager 迁移 chezmoi | 群友踩坑中,关注 6 月那个坑是否已修复 |
观点延伸
当天最值得追问的,不是上下文还能塞多少,也不是该选哪款编排器,而是:哪些信息有资格影响当前决策? 从“写文档顺手修工具”到学习配置后误带作者署名,讨论指向同一个工程问题:信息进入系统容易,限定它的作用范围很难。
1. 新开会话不是拒绝架构,而是最小隔离
群里对重型编排的抵触,有一个合理内核:调整 Mermaid 格式,不该让主任务背上整段排错历史。此时新开会话,是把交付工作与工具维护拆开,而不是逃避复杂性。
但隔离不等于点一下 fork。如果完整历史照搬、双方同时修改同一文件、最后只凭一句“修好了”交接,问题仍在。我的判断是:编排的起点不是多个 Agent,而是明确的输入、产物和验收条件。 能用一份补丁和一个测试结果交接,就先别引入队长与工人;只有依赖调度、冲突处理反复消耗人工时,编排才值得增加复杂度。
2. 记忆不能自动升级成规则
“学过某人的配置,后来生成文件却带上他的署名”,比上下文变长更值得警惕。聊天不足以确定具体机制,但这个例子提醒我们:参考材料中的事实,可能被错误地当成当前任务的约束。
个人知识系统也一样。收藏不等于认同,历史决定不等于永久偏好,示例作者更不等于当前作者。工程上应给长期记忆保留来源、适用范围和失效条件;署名、许可证等字段则从当前项目核对,不能从相似文本继承。记忆的质量,不在于能记住多少,而在于能否拒绝不该迁移的内容。
3. 检索优化要算完成任务的总账
新 grep 的节省幅度在群里是转述,机制仍是推测,不能据此判定索引或某种语言胜出。Python 可以批处理,Shell 也能组合管道;少调用一次工具,不代表少走一次弯路。
真正该比较的是:同一代码版本、同一问题下,能否找到正确位置,漏掉多少依赖,修改后能否及时反映新内容,以及最终完成任务的时间和返工量。返回得少却漏掉关键调用方,是把检索成本转成调试成本。 索引是否划算,也应看更新开销与重复查询收益,而不是仅凭“代码经常变”否定。
可继续实践:做一次上下文隔离对照
选一个“实现功能时顺便修工具”的真实任务,对比单会话到底与独立会话维护工具。固定起始代码和验收测试,记录主任务偏航、交接遗漏、返工次数与总耗时。先证明边界有收益,再决定是否购买编排复杂度。