
外观
Emacs 社区日报 2026-09-04
自动整理自 Telegram 讨论组,每天更新。内容为 AI 摘要,仅作信息索引与回顾。
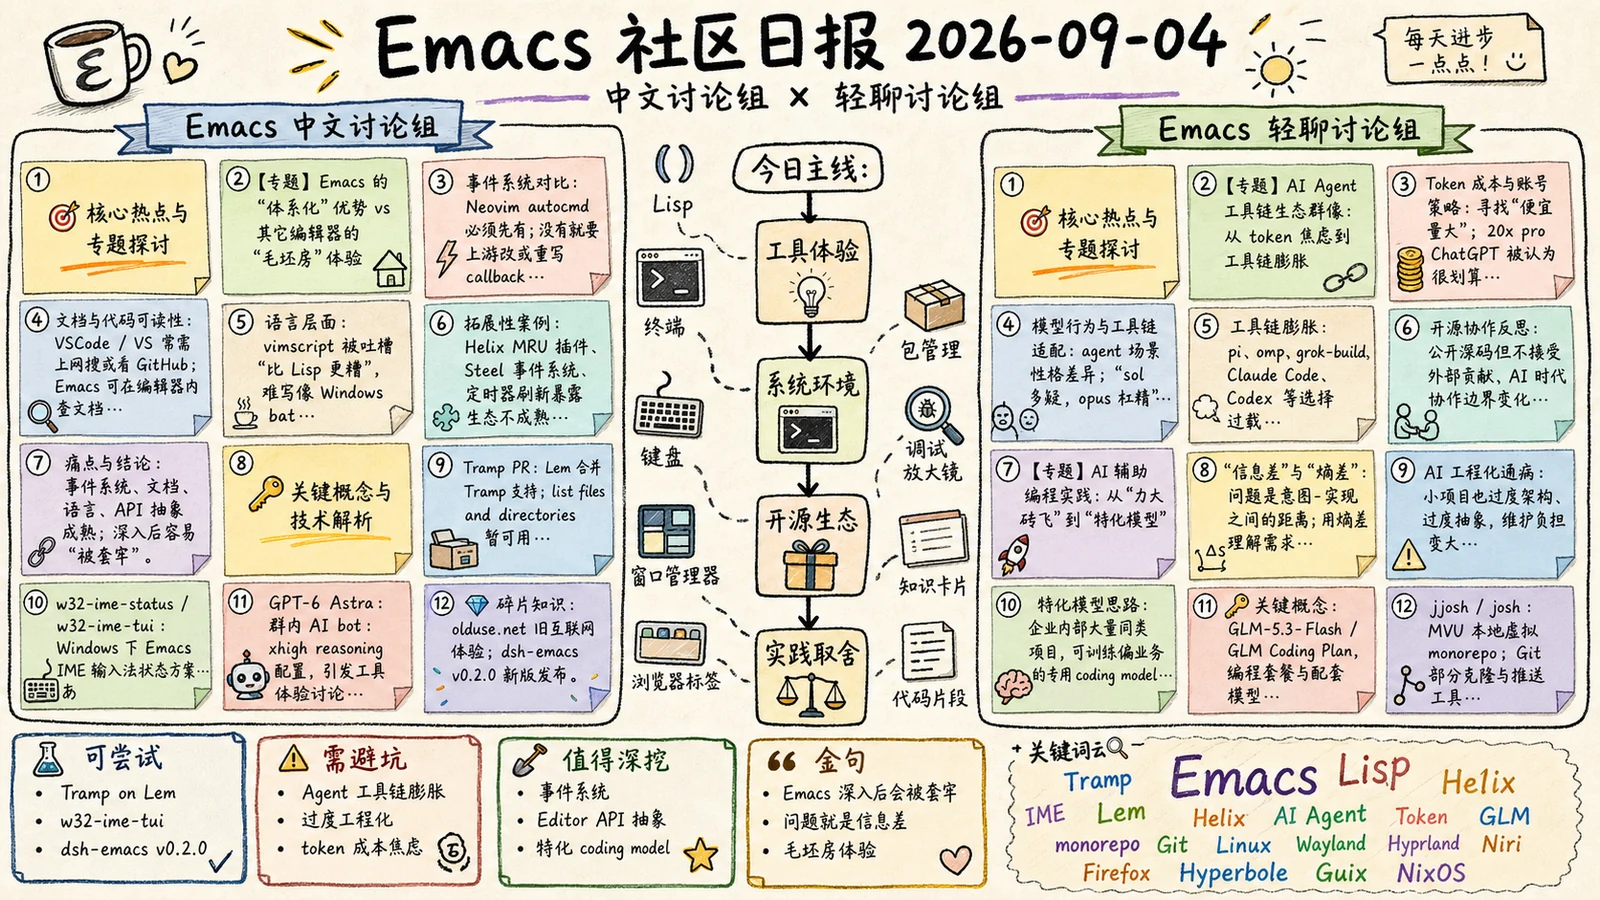
Emacs 中文讨论组
🎯 核心热点与专题探讨
今日有效讨论较少,但有一段跨越多个时间点的深度讨论值得整合为一个专题。
【专题】Emacs 的“体系化”优势与其它编辑器的“毛坯房”体验
群友 @κόσμος 与 @oldosfan 等人展开了一场关于编辑器生态成熟度的讨论,核心观点是:Emacs 在“体系化”程度上远超其它编辑器。
- 事件系统对比:
@κόσμος提到,Neovim 的autocmd事件系统必须先有,没有就需要上游改或重写 callback;而 Emacs 的 hook 体系(如buffer-local variable)成熟且灵活,一旦熟悉便“逃不出舒适圈”。 - 文档与代码可读性:指出 VSCode、VS 等主流编辑器无法在编辑器内查看功能文档,只能上网搜或看 GitHub 代码;而 Emacs 的文档(如
describe-function)高度集成,这构成了巨大的体验差异。 - 语言层面:
vimscript被评价为“比 lisp 更糟糕的语言”,甚至“难写程度和 Windows 的 bat 脚本一样”。Lua 虽现代,但底层的回调机制仍受限于 Vim 命令体系。 - 拓展性案例:
@κόσμος分享了自己为 Helix 编写 MRU 插件时,发现 Steel 作者虽有事件系统却仍用定时器刷新数据,感觉“被绑住手脚”,而 Emacs Lisp 提供了远超 libc 的系统调用抽象(如“libc 没有读取文件夹的 api,而 emacs lisp 有”)。
痛点与结论:群友一致认为,Emacs 的成熟度(事件系统、文档、语言、API 抽象)是其它编辑器难以企及的,一旦深入便会“被套牢”。
🔑 关键概念与技术解析
无明显新增概念,但以下技术细节值得记录:
- Tramp PR:Lem 项目合并了 Tramp 支持(https://lem-project.github.io/usage/tramp/),但“unsupported: list files and directories”,即暂不支持列目录。
- w32-ime-status / w32-ime-tui:群友分享了关于 Windows 下 Emacs 输入法(IME)的 patch,涉及 TSF 输入法 API 不经过消息循环的问题,并推测在 Windows 11 上可能有效。
- GPT-6 Astra:群内出现了一个 AI bot,配置为 OpenAI 的 GPT-6 Astra(xhigh reasoning, with high search),但群友怀疑是反代或 AB 测试账号。
💎 碎片知识与金句拾遗
- olduse.net:一个模拟“旧互联网体验”的网站(类似回归 1990 年代网页风格的复古项目)。
- dsh-emacs v0.2.0:群友
vritser发布了新版本:https://github.com/vritser/dsh-emacs/releases/tag/v0.2.0 - Emacs China 后台机制:后台可在 24 小时后统一“真删除”帖子。
- Gnus 订阅技巧:订阅
emacs-devel后关闭邮件通知,在 Gnus 里将 devel 组的回信 policy 改成smtp,即可不被邮件打扰且任意恢复;也可将邮件筛到特定 mailbox。 - AI bot 折叠争议:多位群友建议将 AI bot 消息默认折叠,因为“太占窗口”,“非常影响看群的欲望”;有人建议将结果放到其它频道。
- telega.el 图片切片:群友
LuciusChen拆出了image-slice(https://github.com/LuciusChen/image-slice),并发现已有类似实现org-sliced-images(https://github.com/jcfk/org-sliced-images)。 - 金句:“别编辑器一旦开始接触要触发一个 documentdidopen, buffer hook, focus-lost,你试试看就知道了。”
🛠️ 值得深入研究的点 (Follow-up)
- dsh-emacs:一个新兴的 Emacs 发行版/配置框架,值得关注其 v0.2.0 更新内容。
- w32-ime-tui:Windows 下 TSF 输入法 API 的 Emacs patch,若能在 Win11 上解决
w32-ime的 lisp API 问题,将是重要的上游贡献。 - Lem Tramp 支持:Lem 项目合并 Tramp 后,仍需完善“列出文件目录”功能,值得跟踪其后续进展。
- GPT-6 Astra 反代风险:群内出现了疑似“提前访问”的模型配置,但未确认真实性,可作为安全/合规话题留档。
观点延伸
中心判断:Emacs 的优势不只是“老而全”,而是它把编辑器做成了一个可观察、可介入、可重组的运行时。当天关于 hook、buffer-local variable、内置文档、TRAMP、Windows IME patch、AI bot 折叠的讨论,其实都指向同一个问题:工具到底是用户控制回路的一部分,还是只能被用户绕着用。
1. “体系化”不是功能多,而是插入点可靠
群里说 Neovim、Helix 像“毛坯房”,狠但不空。真正的差别在于:当你要做 MRU、focus-lost、documentdidopen、buffer 级状态、回调后置扩展时,系统有没有给你稳定的一等入口。
如果没有事件,只能等上游加;如果有事件但语义不够,只能重写 callback;如果最后靠定时器刷硬盘,那就说明扩展层还没有进入运行时内部。这不是审美问题,是工程可验证的问题:同一个插件需求,统计需要多少轮询、多少全局状态、多少 monkey patch、多少上游改动,就能看出平台成熟度。
Emacs 的 hook、advice、buffer-local、文件和目录 API,价值就在这里:它不是给用户一组命令,而是给用户一套“接管系统行为”的接口。
2. 内置文档是扩展系统的一部分,不是帮助菜单
群里提到 VSCode、VS 往往要上网搜文档或看 GitHub,而 Emacs 可以在编辑器内 describe-function。这点容易被低估。
文档如果不能在运行环境里被查询、跳转、验证,它就不是系统的一部分,只是外部说明书。Emacs 的优势是:函数、变量、keymap、mode、hook、源码、文档处在同一个可探索空间里。对普通用户,这是学习曲线;对插件作者,这是调试器;对长期维护者,这是知识系统。
所以 Emacs 的“套牢”并不只是习惯依赖,而是迁移成本来自真实能力差:一旦你习惯了在工具内部理解工具,其它编辑器的“去网页搜索答案”就会显得像断开的工作流。
3. AI bot 的问题不是 AI,而是抢占默认界面
当天另一个有张力的点是 AI bot 占窗口、希望默认折叠或移到其它频道。这个问题和 Emacs 讨论并不割裂:好的工具应该进入用户控制回路,而不是劫持用户注意力。
群聊里的 AI 能力如果默认铺满窗口,本质上是把“按需查询”变成“公共噪音”。工程判断很简单:默认折叠、显式触发、结果可展开、长回答外置、频道分流,都是降低注意力税的必要设计。否则模型越强,污染越强。
可继续实践
可以选一个小需求做横向实验:实现“最近打开文件 MRU 加焦点离开自动保存”,分别在 Emacs、Neovim、Helix、VSCode 中实现。记录四项指标:是否需要轮询、是否需要上游能力、状态是否能 buffer-local 化、文档能否在编辑器内闭环查到。这个实验比抽象争论更能说明:编辑器生态的差距,最终不是插件数量,而是运行时可塑性。
Emacs 轻聊讨论组
🎯 核心热点与专题探讨
今天的讨论围绕几个核心话题展开,其中关于 AI Agent 工具链的使用体验与选择 的讨论最为持久且深入,几乎贯穿全天。
【专题】AI Agent 工具链生态的群像观察:从 token 焦虑到工具链膨胀
群友们围绕多个 AI Agent 工具展开了长线讨论,核心痛点集中在 token 成本、模型行为差异、工具链集成方式以及开源协作模式上。
- Token 成本与账号策略:群友普遍在寻找“便宜量大”的 token 来源。有人指出“20x pro的ChatGPT就是最便宜的”,也有人提到 ChatGPT 礼品卡可以在闲鱼购买。对于没有 Visa 卡的用户,这构成了不小的门槛。智谱的夜间畅用活动和“重置卡”机制成为另一个薅羊毛热点,群友研究如何“把worker绑成5.3-flash”以及利用多账号获取重置卡。
- 模型行为与工具链适配:讨论深入到不同模型在 agent 场景下的性格差异。群友总结:“sol多疑,opus杠精…”。Opus 被吐槽“完全不遵守AGENTS和CLAUDE”,GPT 则被指“太注重工程化,哪怕是小项目”、“太注重测试,哪怕是小改动也跑全量”,且“不太会写文档”。一位群友的痛点极具代表性:“昨天我就是改动了几个地方,他跑测试跑了4个小时”。这导致部分人转向手动控制,例如“重构的时候,只让它盯住几个例子最终的buffer渲染效果和交互的性能这两个指标”。
- 工具链的膨胀与选择:市面上出现了大量 agent 工具,如 pi、omp、grok-build、Claude Code、Codex 等,群友对此感到困惑和疲劳。“grok咋搞的这么乱,grok build/grok cli/grok agent/grok bot”。有人偏好 pi 的“确定感”,因为它“协议化”、“蚁群架构”;有人认为“claude的agent是最开箱即用的”,但也担心其“喜欢搞点小手脚”,建议将其隔离在 VPS 上使用。
- 开源协作模式的反思:讨论也触及了 AI 时代开源合作的现状。有群友指出 grok-build“公开源码但是不接受外部贡献,dsh也是这样的”,认为代码 review 是根本原因,但连 issue 都不允许提则显得过于封闭。这引发了“ai时代大家都vibe 这开源合作还能搞么”的广泛质疑。
【专题】AI 辅助编程的实践反思:从“力大砖飞”到“特化模型”
这个专题在上午的讨论中逐渐成型,从一次对南京大学“生成式软件工程”课程的推荐开始。
- “信息差”与“熵差”:群友分享了 jyy 的课程观点,核心总结为“问题就是【信息差】,意图-实现之间的距离”。有群友用“熵差”自造词来辅助理解,认为“造词没问题,主要看后续能否围绕这些构建起一套完整的有效方法论”,但也有群友对“方法论祛魅”,强调“除非是真方法论”。
- AI 的工程化通病:群友一致认为,当前大模型在编程时存在明显的“过度工程化”倾向,对小项目来说是负担。“太注重工程化,哪怕是小项目。太注重测试,哪怕是小改动也跑全量。太注重异常处理”。一位群友分享经验:“小项目直接在根目录把所有文件写出来就可以了,不需要多级目录”。
- 特化模型的思路:针对 AI 的“通用性”和“不知道项目的偏重”问题,群友提出了公司内部特化模型的思路:“如果有大量同类项目…可以特化小模型来处理业务领域的相关问题”。然而,训练成本是现实障碍,“如果就一点点也就算了,那是几十万条”。数据标注再次被提及,“几毛钱一条数据标注是绝对划算的,最起码是真人”。
🔑 关键概念与技术解析
- GLM-5.3-Flash / GLM Coding Plan:智谱推出的编程套餐及配套模型。该模型是 GLM-5 系列首个原生多模态模型,在错峰时段(夜间)免费使用或额度翻倍,旨在降低 token 成本。群友讨论其速度极快,可达 160 token/s。
- jjosh:一位群友正在设计的项目,基于 MVU (Model-View-Update) 架构,目的是操作本地虚拟 monorepo,同时包装了
josh和jj(Jujutsu) 的 CLI。 - josh:一个开源工具,用于在 Git 仓库之间进行部分克隆和推送,解决 monorepo 和 multirepo 之间的转换问题。群友推荐其解决跨语言(如 Python、Clojure、TS)项目合并或拆分的问题。
- delta db (Zed):群友对 Zed 编辑器中的
delta db功能持观望态度,认为其亮点可能在于“什么都能 comment”,但“乍一看和普通的agent工具没什么区别”。 - PAIR (Personal AI Router):英伟达发布的开源工具,能将家庭网络中闲置的算力(如 RTX 显卡、M4 芯片)汇集起来用于本地 AI 推理。群友对此看法褒贬不一,有人吐槽“赚那么多钱了,还想让人共享算力”,也有人认为这可能是解决算力成本的一种思路。
- AstrBot / Hermes / OpenClaw:用于接入消息平台(如 Telegram)并实现 AI 自动回复的框架。群友讨论如何让 AI 以个人身份而非 bot 身份回复,并提及有项目因在群内使用而被封禁。
- monk.party:一个共享 API 服务的平台,群友推荐其作为“量大管饱”的子任务模型来源,并提到其已全系标配 Gemini 3.8 Flash 模型。
💎 碎片知识与金句拾遗
- 群友对 AI 编程体验的生动吐槽:“cs学生没token可以直接退学了,哈哈”。
- 关于 AI 过度工程化的观察:“现代网页就流行单页应用,搞组件化更新dom树。后面我发现这些工程化对小项目来说是负担”。
- 一条关于 AI 翻译的冷知识:“在花频道这个翻译错误也太逆天了 还没改过来 草台班子”。
- 关于本地模型体验的分享:“被 gpt 的速度折磨之后,现在用着本地模型感觉无比的舒服”。但本地模型也有“一问模型自己是谁,直接回答的豆包”的问题。
- 关于 AI 逆向能力的讨论:“听说ai逆向现在强无敌”,但群友质疑“我也没看到遍地游戏外挂啊”。
- 关于 AI 哄对象的小红书见闻:“我看小红书有人用ai哄npy”,涉及通过 OCR + ADB 控制微信的骚操作,群友评价“这有啥难的,甚至不用ocr,直接给ai不更好,就是费token”。
- 关于文档编辑的思路:“给它几篇你觉得满意的文档,看看有没有什么特性…然后ai只改edit的部分”。
- 群友分享了一个手写 PNG 教程的计划:“教人们如何直接编写二进制”,准备发布到 X 和 YouTube。
- 关于阅读工具的选择:群友用 Kindle 作为“泡面盖板”,有人用 MarginNote,有人“天天看文档”。
- 关于大模型训练的痛苦回忆:“我之前调权重比的时候调得心态炸裂…动不动就过拟合”。
- 群友对 OpenAI 智能体事件的评价:“太魔幻了,开始了”,并分享了相关新闻链接。
- 对命令行词典工具的需求探讨,群友推荐了
dict-line、goldendict、sdcv,但对现有方案均表示“体验还有点问题”。
🛠️ 值得深入研究的点 (Follow-up)
- pi (earendil-works) 的
harness-v2分支:群友正在重构 pi 以支持“多 agent 并行协作的结构”。该分支的文档(j4/packages/agent/docs/harness-v2.md)值得关注,这可能代表了个人 AI 助手从单一代理向协同工作流演进的趋势。 - 英伟达 PAIR (Personal AI Router):该工具试图将家用闲置 GPU 组成分布式推理网络。这是一个去中心化 AI 算力的重要尝试,尽管群友反应褒贬不一,但值得持续关注其技术实现和生态发展。
- 本地部署搜索引擎给大模型用:群友分享了一个知乎专栏,介绍如何“本地部署一个搜索引擎,给大模型用”,并已有人成功部署。这指向了 RAG 技术的一种轻量级、定制化的实践方向。
- monk.party:作为一个共享 API 的平台,它通过合租服务器的方式降低了 token 成本。这种“福利局”模式是否可持续、以及其背后的成本模型,值得研究。
- Grok-Build 的 Rust 实现:尽管群友对其开源协作模式有异议,但其作为 Rust 编写的 agent 工具,在性能、并发模型和系统集成方面可能有独特优势,值得深入分析。
观点延伸
今天最值得咀嚼的不是“哪个 Agent 更好用”,而是一个更硬的判断:AI 编程的瓶颈正在从模型能力转向控制面设计。模型已经会写代码,但它不知道什么叫“对这个项目刚刚好”。所以真正的工程能力,不是让 Agent 更自由,而是把它的自由度压进可验证的轨道里。
1. “跑测试跑 4 小时”不是勤奋,是控制面失败
群里反复提到 AI 过度工程化、过度测试、过度异常处理,小改动也全量跑测试。这不是模型笨,而是目标函数太粗:只告诉它“修好”,它就会把所有能增加安全感的动作都堆上去。
更好的做法是把验收指标显式化。比如有人重构时只让它盯住“最终 buffer 渲染效果”和“交互性能”两个指标,这比抽象地要求“保证质量”强得多。对 Emacs 这类交互系统尤其如此:很多正确性不是单元函数级别的,而是 buffer 状态、光标行为、滚动体验、响应时间这些端到端现象。Agent 不该默认拥有测试策略,测试策略应该是项目给它的。
2. 工程化不是越多越好,而是复杂度投资
“小项目根目录几个文件就够了”“单页应用不一定需要完整前端工程化”,这些吐槽背后其实是一个朴素的软件工程原则:工程化本身也是复杂度。目录、构建、组件、抽象、测试、异常处理都不是免费午餐,只有当它们降低的维护成本大于引入成本时才成立。
这也是为什么通用模型容易偏。它学到的是大量“成熟项目的平均形状”,但个人工具、一次性脚本、Emacs 插件、小型知识系统往往需要的是低仪式感、高可改性、短反馈链。让 Agent 照搬工业项目模板,等于把未来可能出现的问题提前变成今天真实存在的负担。
3. “确定感”比“智能感”更稀缺
群里夸 pi 的点很关键:协议化、能扩展、知道它在干什么。这说明 Agent 工具链的竞争点不只是模型接入数量,而是执行过程是否可观察、可约束、可恢复。jj undo、局部 edit、只给 emacsclient 工具、多 Agent harness,本质都是在把不可控的生成过程切成可回滚的小交易。
可继续实践的方向:为自己的 Emacs/知识系统项目建立一套“Agent 验收协议”。每类任务只定义少数硬指标:文档改动只允许局部 diff,重构必须给交互样例,UI 修改必须有截图或性能观察,代码任务必须说明跳过哪些测试以及原因。模型可以换,token 来源可以换,但这套控制面一旦稳定,才是真正可积累的个人工程资产。