
外观
Emacs 社区日报 2026-08-29
自动整理自 Telegram 讨论组,每天更新。内容为 AI 摘要,仅作信息索引与回顾。
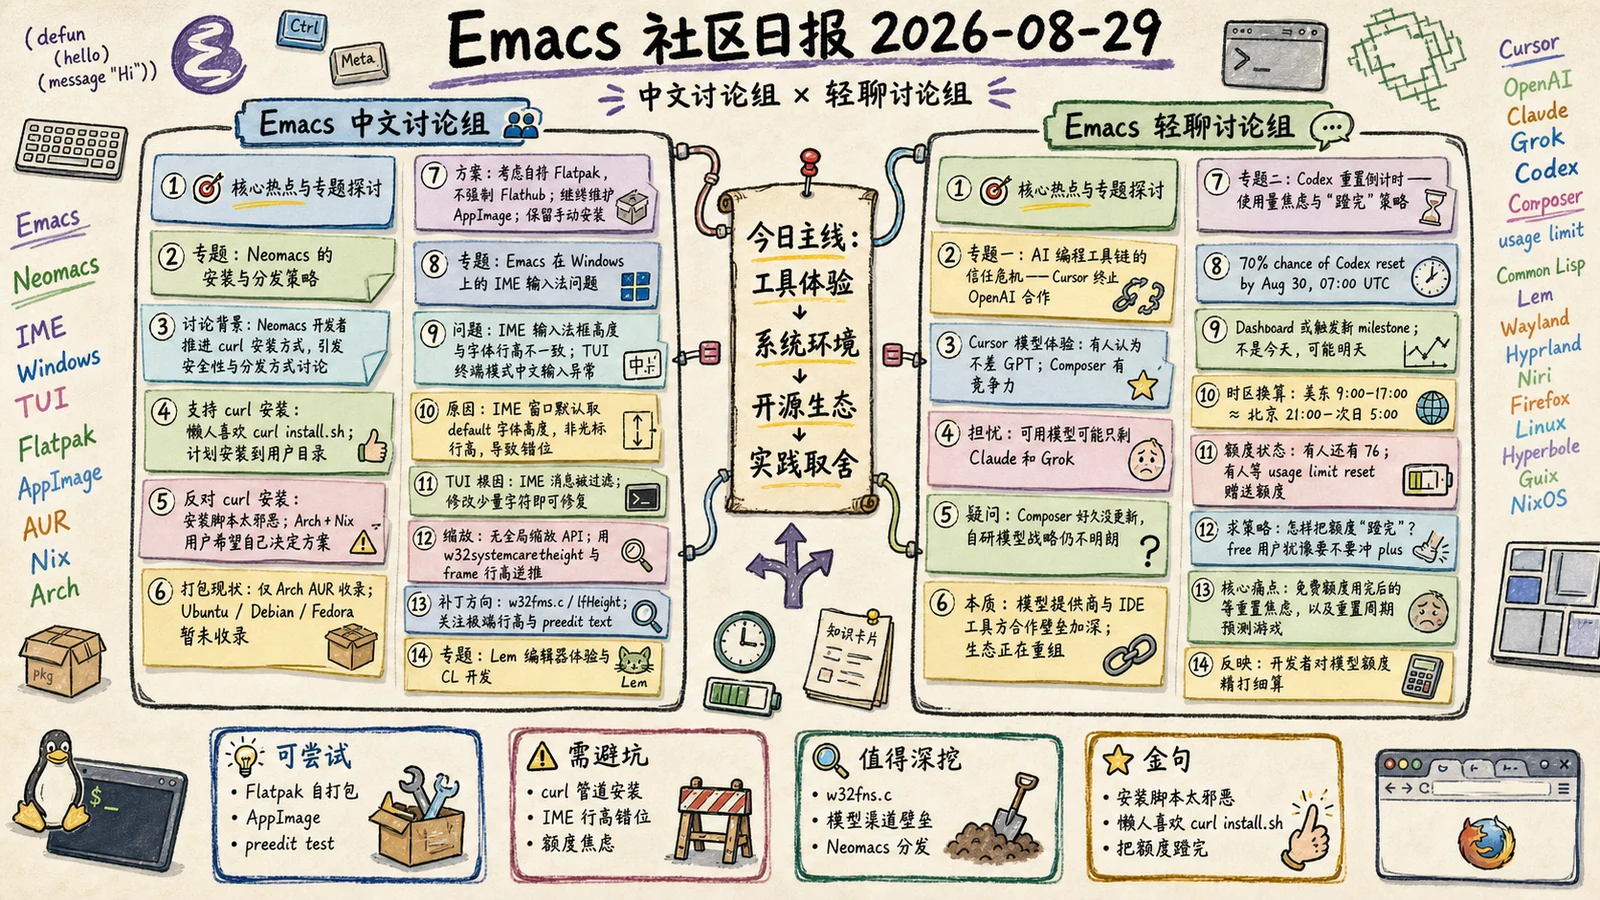
Emacs 中文讨论组
🎯 核心热点与专题探讨
专题:Neomacs 的安装与分发策略
- 讨论背景:Neomacs 开发者正在推进
curl https://neomacs.org/install.sh的安装方式,引发群内关于安全性和分发方式的讨论。 - 各方观点:
- 支持 curl 安装:认为“对于懒人来说,他们应该喜欢 curl install.sh”,并计划将 Neomacs 安装到
~/.local/bin/和~/.local/share/。 - 反对 curl 安装:认为“安装脚本还是太邪恶了”,且“如果你是一个在 arch 上用 nix 的用户,我应该自己决定用什么方式装”。建议维护 Flatpak 或 AppImage 包。
- 打包现状:目前仅 Arch AUR 收录 Neomacs,Ubuntu、Debian、Fedora 均未收录。开发者尝试提交 Flatpak PR 但被维护者关闭。
- 支持 curl 安装:认为“对于懒人来说,他们应该喜欢 curl install.sh”,并计划将 Neomacs 安装到
- 结论与方案:开发者考虑直接自行打包 Flatpak(不强制上传 Flathub),并继续维护 AppImage;同时强调“手动安装”也是可行的。
专题:Emacs 在 Windows 上的 IME 输入法问题
- 问题描述:Emacs 在 Windows 上 IME 输入法框在汉字高度高于默认字体行高时无法占满整行,且 TUI(终端模式)下无法输入中文。
- 深入分析:
- IME 窗口字体高度默认获取 default 字体高度,而非光标(行高)高度,导致中英字体高度不一致时出现错位。
- TUI 下无法输入中文的根因是代码 bug——IME 消息被过滤(疑似“vim 间谍”故意设置分支),仅需修改几个字符即可修复。
- 缩放问题:无 API 可获取全局缩放系数,只能通过
w32_system_caret_height与 frame 行高逆推;且 IME 字体样式与全局不一致,需访问 elisp 设置的字体大小。
- 补丁方向:尝试通过
w32fns.c中lfHeight设定解决,但需考虑极端行高下的显示效果;已有 preedit text 渲染 patch 但未被 emacs-devel 采纳。
专题:Lem 编辑器体验与 CL 开发
- 讨论背景:群友分享 Lem 编辑器的使用体验,引发关于其在 Common Lisp 开发中的优势讨论。
- 核心观点:
- Lem 是 Common Lisp 编写,支持 vi-mode、类似 SLIME 的体验,对 CL 开发“很爽”。
- 相比 Emacs + SLY,Lem 在 CL 开发上的体验更好;但代码实现方案“不高”,依赖大量 CFFI。
- 项目活跃度高,已“拥抱 AI 社区”,如 git-gutter-mode 是作者用 AI 写的,被认为“不可能烂尾”。
- 相关工具:群友推荐 SLY(
https://github.com/joaotavora/sly.git)作为 Emacs 写 CL 的最佳包;并分享自己的 Lem 配置(https://github.com/MasterCsquare/.lem/blob/main/init.lisp)。
🔑 关键概念与技术解析
- IME(Input Method Editor):输入法编辑器,用于在图形界面或终端中组合输入法字符(如中文)。在 Emacs Windows 端,IME 字体高度、缩放和消息过滤是常见问题点。
- Double Buffering:双缓冲绘制,通过避免频繁刷新画面来防止撕裂。Emacs 28 在 Windows 上实现了此功能,但其他平台早已具备。
- Neomacs:一个正在开发的编辑器,具有 buffer 切换动画、workspace 切换等特性,目前支持安装到
~/.local/bin/。 - Lem:基于 Common Lisp 编写的编辑器,支持 vi-mode,强调 CL 开发体验,并集成了 AI 辅助功能。
- CFFI(C Foreign Function Interface):Common Lisp 调用 C 函数的外部函数接口,Lem 依赖大量 CFFI 以实现底层功能。
💎 碎片知识与金句拾遗
- Neomacs 安装路径:开发者计划将 Neomacs 安装到
~/.local/bin/neomacs和~/.local/share/neomacs/,但被质疑“安装脚本还是太邪恶了”。 - Emacs TUI 中文输入修复:群友发现“TUI 下 Emacs 输入不了中文”的 bug,参考测试程序:
https://github.com/zHaOdANiuu/w32-ime-tui,并调侃“有 vim 间谍混进来了”。 - Windows 笔记软件讨论:群友推荐 Siyuan(自带 WebDAV,但搜索不支持多关键词)、Helixnotes;也有人表示“不记笔记”。
- Emacs 配置心得:群友分享“自己写的 mode”,用 menu 键作 prefix 定义按键,caps 设置成 menu。
- man page 变化:有群友感叹“现在的 man page 都这么花哨了,还加超链接”,并推荐 org-mode 的 denote 包。
- 核心成员爆料:群内有“the true core maintainer”(老风扇),是 Emacs Android 版的作者,也是“伟大的 Emacs double buffering 实现者”。
🛠️ 值得深入研究的点 (Follow-up)
- Emacs IME 字体渲染优化:群友提出的
lfHeight设定方案和 preedit text 渲染 patch,值得关注其后续演进,尤其是与 emacs-devel 的讨论进展。 - Neomacs 打包策略:开发者考虑自行打包 Flatpak 而非上传 Flathub,这一策略值得跟踪,因为它可能影响 Neomacs 的分发生态。
- Lem 编辑器的 AI 集成:Lem 已开始用 AI 生成代码,未来可能成为编辑器 AI 集成的标杆,值得关注其“不会烂尾”的社区承诺。
- W32 TUI 中文输入修复:参考测试程序
w32-ime-tui和相关分支 bug 修复,可能成为 Emacs 官方接受补丁的前置条件。
观点延伸
中心判断:今天最值得咀嚼的,不是某个新编辑器或某个 Windows 补丁,而是同一条工程原则在不同层面的反复出现:把“方便”交给默认路径,把“控制权”留给用户,把复杂性放进可维护、可验证的边界里。Neomacs 讨论的是分发边界;IME 讨论暴露的是状态边界;Lem 的 AI 话题则触及维护边界。
1. 一键安装的成本,是替用户做了不可见的决定
curl install.sh 能照顾“不想折腾”的用户,但它把信任集中到一个脚本:用户不仅接受程序,也接受安装位置、文件写入方式和后续排障路径。群里提出 AUR、Nix、Flatpak、AppImage 和手动安装,并不是保守主义,而是在要求“安装”成为可替换的策略,而不是作者预设的唯一入口。
更稳的做法不是取消一键安装,而是把它降级为薄薄的便利层:发布物可独立下载,脚本内容可审查,安装结果可列出、可卸载,版本和校验可复现。这样懒人得到低摩擦,谨慎用户也不必牺牲自主权。
2. IME 问题说明:补丁行数很小,系统责任却可能没有边界
lfHeight 能改善输入法框的视觉错位,但讨论很快触及全局缩放、Elisp 字体设置、光标绘制时机和 TUI 消息过滤。这说明真正的问题不是“某个高度算错”,而是行高、字体、输入事件和绘制状态分别由不同层维护,却缺少稳定的共同契约。
TUI 下中文输入被过滤,也说明一个看似平台限制的现象,可能只是事件路径上的分支错误。可维护的修复不应只追求“改几字符后能用”,还要覆盖中英字体混排、极端行高、缩放变化、图形界面、TUI 和 preedit 消除。截图能证明效果,事件测试才能证明原因没有再次被藏起来。
3. “拥抱 AI,所以不会烂尾”需要换成可检验的判断
Lem 的讨论里,AI 生成 git-gutter-mode 被视为项目活力的信号;这个直觉有价值,但不能直接推出长期可靠性。AI 降低的是实现功能的边际成本,不自动提供架构一致性、审查责任和维护者判断。
真正值得观察的是:生成代码是否融入既有设计,是否有测试和用户反馈,出了 CFFI 或平台兼容问题后谁能定位并修复。对 Emacs、Lem 这类可扩展系统,社区持续产出并维护 patch 的能力,比“用了 AI”更接近不会烂尾的证据。
可继续研究/实践:把当天讨论转成一张验收表:安装检查“能否审查、卸载、复现”;IME 检查“事件路径和多字体、缩放组合”;AI 贡献检查“审查、测试、回归和责任人”。凡是只能靠“看起来能用”通过的地方,都是下一处维护债务的候选点。
Emacs 轻聊讨论组
🎯 核心热点与专题探讨
专题一:AI 编程工具链的信任危机——Cursor 终止 OpenAI 合作
今天群内讨论最热烈的事件是 OpenAI 宣布终止与 Cursor 的合作关系。起因是 Tibo(可能是一位开发者/意见领袖)在 X 上发布了 OpenAI 不再通过 Cursor 提供模型访问的公告,理由是"信任问题",生效日期为 11 月 12 日。
群友反应:
- 有人认为"cursor 感觉也不差 gpt 这些个模",说明 Cursor 自研的模型(如 Composer)已经积累了一定竞争力
- 有人担心剩下的可用模型只剩 Claude 和 Grok
- 也有人指出 Cursor 自己做的模型(Composer)已经"好久没更新了",暗示 Cursor 的自研模型战略仍不明朗
本质讨论点:模型提供商与 IDE 工具方的合作壁垒正在加深。OpenAI 收紧渠道、Cursor 转向自研模型,这个生态正在经历一场"去 OpenAI 化"的过程。
专题二:Codex 重置倒计时——使用量焦虑与"蹬完"策略
群内大量讨论围绕 Codex 重置周期展开。Tibo 发布了两条相关帖子:
- ">70% chance of a Codex reset by Aug 30, 07:00 UTC",并强调"有重置的时机和地点,但不是今天"
- 后续又说"Looking at the dashboard we might hit a new milestone to celebrate tomorrow. Hold on to your Codex"
群友推理:
- "老外的 soon 应该不会太久?还特地强调了不是今天" → 推测重置发生在明天(8/30)
- 具体计算:美东时间 9:00–17:00 = 北京时间 8/30 晚上 21:00 到 8/31 凌晨 5:00
- 有人表示"我还有 76",有人在等 usage limit reset 赠送的额度,"求一个能蹬完的办法"
- 有人提出"我现在是 free,还在犹豫要不要冲 plus"
核心痛点:免费额度用完后的"等重置"焦虑,以及对"重置周期"的预测游戏。这反映了开发者对模型使用额度的精打细算。
专题三:AI 生成代码的可维护性 vs 可复现性
从"群友们觉得 vibe 出来的代码真的不可维护吗"发起的深度讨论:
- 可维护性的悖论:有人认为"AI 写代码、AI 看、AI 测、AI 用"可以形成闭环,但也有人指出"如果不知道具体方向,AI 会用各种方式实现,甚至多层堆砌,然后就很脆弱"
- 具体案例:Lucius 分享了他用 AI 实现 Swift 下 tab + Liquid Glass 效果 + 长按二级菜单的经历——AI 用了三四种实现方式叠在一起,改个覆盖范围就能崩
- 可复现性优先论:有人说"比可维护性现在更关键的是可复现",只要 AI 写的代码有完整 test 和 CI/CD pipeline,"应该还是不慌"
- UI 测试困境:UI 自动化测试(类似 Web 的 xpath 方式)还没成熟,"如果不能自动化测试,那对 AI 就不太友好",因为每次改动循环一次很耗时
- 核心观点:对于 AI 来说"没有啥是不可维护的",但人类 review 不过来,所以实际价值有限
🔑 关键概念与技术解析
neomacs + nix flake + darwin:群友尝试在 macOS(darwin)上运行 neomacs(一个基于 Common Lisp 的编辑器/文档系统),通过 Nix flake 来管理依赖。这是一次跨平台兼容性探索。
Composer(Cursor 自研模型):Cursor 自家推出的模型,群友评价"好久没更新了",暗示其进展缓慢。
Codex 重置(reset):指 OpenAI 对 Codex 模型使用额度进行周期性重置(通常是一周),开发者可以在此期间重新使用全部额度。社区通过预测重置时间来做"冲刺"。
vibe coding:一种依赖 AI 生成代码的编程方式,强调"描述效果而非方向",群友认为这种方式生成的代码"可维护性一般"。
dsh 插件:群友讨论的一款"非常好的 dsh 插件",视频链接指向 B站。dsh 可能是一个 Emacs 或类似编辑器插件体系,用于实现类似代码 review 批注功能。
sillytavern(酒馆):一个开源 AI 角色扮演/聊天客户端,群友讨论其在 Claude Pro 上的用量消耗("一个 claude pro 只够 3-5 次发送"),说明角色扮演场景对 token 消耗极高。
Kimi k3:月之暗面(Moonshot)的最强模型,群友评价"编程题测试分数比 sol 还要高",但"token 效率低""逆天 70 分钟",并且"几乎国模最贵的",还出现大量 429 限流。对比结论是"能跟 Grok 打一架"。
sing-box:一个通用的代理平台工具,群友简单推荐"好用"。
💎 碎片知识与金句拾遗
"AI 写,AI 看,AI 测,AI 用 🫠 主打一个闭环" —— 对 AI 代码生产闭环的调侃式总结。
"AI 会用各种方式实现,甚至多层堆砌,然后就很脆弱" —— 描述 AI 生成代码常见的实现方式组合问题。
"Lucius:我为了实现 Swift 下的 tab 且要保留 Liquid Glass 效果,长按有二级菜单,他弄了三四种方式实现叠在一起。感觉 UI 是样子的,不好自动化测试,改个覆盖范围都能崩" —— 一个非常具体的 AI 代码脆弱性案例。
"现在 AI 写的代码……如果没有 AI,我编译都编译不出来" —— 承认 AI 代码的"黑盒"属性,人类已无法独立维护。
"其实严格的 spec prd 也是代码,伪代码" —— 关于"代码"定义的延伸思考:规范和 PRD 本质上是给 AI 的"代码"。
"可维护性这个概念感觉就很难定义。对于 AI 来说,没有啥是不可维护的 🫠" —— 对 AI 时代"可维护性"概念的重新解构。
"Google 的模型在细分领域很强,比如 OCR 文字识别是天花板级别的。你办公室数据库里那一堆文件材料,交给 Google 准没错" —— 对 Google 模型在 OCR 等垂直领域的肯定。
"google 已经放弃了最强大模型的比赛。它目前需要的是,是一个可以和自己的生态好好配合的模型,而不是最强大模型" —— 对 Google 模型战略路线的观察。
"假如能有个 LLM 能够接管或者优化美团的工作流或者算法的话,也就十分赚了" —— 对垂直行业大模型应用场景的想象。
"美团抽成太狠了,还有类似强制的点击量计算的推广费,还有强制店家参加活动补贴红包,已成恶龙" —— 对美团平台政策的吐槽,与 AI 无关但源自群内真实讨论。
"我现在都是自己慢慢看,vibe 了一个 mode,基本的快捷键匹配以后还是很爽的" —— 分享 Vim 快捷键配置心得。
"字体码点回调会被 default 字体覆盖,这个字体回调只能设置 default 字体没有覆盖的字体范围" —— 一个具体的终端字体渲染问题解决经验。
"我现在用 AI 都是基本上靠 AI 参谋意见,每次让 AI 生成一堆,我自己多问问为什么这么选" —— 一种"AI 辅助决策"的使用模式。
🛠️ 值得深入研究的点 (Follow-up)
- dsh 插件(B站视频 BV1cQ8g6VEVz):群友高度评价的一个插件,实现了类似代码 review 批注功能。群友认为"应该在 emacs 做这个",并提到"etaf 也许可以"。这是一个值得关注的编辑器生态新工具。
- Emacs 批注工具(reviewer.el):reddit 上有人写了类似的代码批注工具,与上面 dsh 插件功能重合,值得对比研究。
- Codex 重置预测工具(codex-radar / codex-resets.com):社区围绕 Codex 重置周期开发的预测跟踪站,体现了模型使用量管理的精细化趋势。
- 统一 IM markup 解析层:群友提出"各种 IM 的 markup 不统一,应该做一个统一的解析层",这是一个潜在的开发方向(跨 Slack/Telegram/Discord 等平台的格式转换层)。
- AI UI 自动化测试方案:群友讨论中提出"UI 自动化测试能否像 Web 那样 xpath",这是 AI 生成 UI 代码可维护性的关键瓶颈,值得深入研究。
观点延伸
中心判断:今天关于 Cursor、Codex 和 vibe coding 的几条讨论,实际上指向同一个问题:AI 工具的竞争力,正在从“能不能生成代码”转向“能不能把不确定性关进工程边界”。模型会更换,额度会重置,IDE 也可能与供应商拆伙;真正应该稳定下来的,是项目的约束、测试和可迁移流程。
1. 可复现是底线,不等于可维护
“AI 写、AI 看、AI 测、AI 用”确实可能形成闭环,但 Swift 的 tab、Liquid Glass、长按二级菜单案例说明,代码能跑只是第一关。AI 为了实现一个视觉效果,可能叠加多种实现路径;结果是界面看起来正确,改一个覆盖范围却整体崩溃。
问题不在于 AI 代码是否“天然不可维护”,而在于维护责任已经从逐行阅读,转移到了控制状态、边界和验证信号。完整测试、构建和发布流水线,只能证明某些路径可以重复,不代表架构没有互相打架。尤其 UI 如果只能靠截图判断,AI 每轮修改都在猜;如果能提供稳定标识、可访问性树、状态断言和明确的状态转移,反馈才足以让实现逐步收敛。
人类无法无限扩大 review 产能,因此更现实的做法不是审查每一行,而是审查少量高价值契约:状态由谁持有,组件边界在哪里,交互优先级是什么,哪些行为必须保持不变。严格的 spec/PRD 在这里确实像“伪代码”,但它必须能被测试和工具读取,而不能只是自然语言愿望。
2. 模型供应链也应按可替换依赖设计
OpenAI 与 Cursor 的信任冲突,以及群里围绕 Codex 重置、额度和套餐的焦虑,说明模型已经是生产系统的外部依赖,而不是编辑器里的一个按钮。依赖一旦受到渠道、价格或策略影响,团队就会被迫重新安排工作。
因此,项目不应把关键知识藏在某个模型的上下文里,而应在仓库中保存规格、测试、评测样例、变更记录和决策理由。模型负责提出补丁,工程系统负责判断补丁是否合格。这样更换模型才是一场可测的兼容性测试,而不是从头重新适应一套“神谕”。
可继续研究/实践
选一个带状态的 Emacs 或 Web UI 功能,先写状态机、语义定位和验收断言,再让两个模型分别实现。比较首版速度之外的指标:回归次数、失败类型、人工修复时间,以及换模型后能否重放并复现。这个结果,比单次编程 benchmark 更接近 AI 在真实工程中的价值。